
Bases de datos e ingeniería de datos · IA y agentes · Cloud, DevOps y LLMOps
Lakehouse AI Studio para Databricks: pipelines, RAG y agentes de IA
Por David Gadyan · Publicado el
Un acelerador full-stack para proyectos de integración de IA en Databricks: datos públicos, en la nube y locales fluyen por bronce, plata y oro con comprobaciones de calidad, cuarentena y conciliación, y después alimentan preguntas en lenguaje natural respondidas con su SQL, búsqueda en documentos, agentes antifraude cuyas acciones de riesgo esperan a una persona, y un copiloto de operaciones que diagnostica un fallo real por falta de memoria a partir de los logs de Spark. Cada tarea de IA corre en un modelo local o en uno alojado. Probado con 2,96 millones de viajes reales de taxi de Nueva York y datos de fraude sintéticos; React, FastAPI, PySpark y Delta, pgvector, MLflow, LangGraph, 88 tests de backend. No es un producto oficial de Databricks.
El problema
Las ofertas de trabajo de Databricks y los proyectos de clientes publicados piden lo mismo una y otra vez: llevar datos de muchas fuentes a un lakehouse gobernado, demostrar las cifras y después poner IA encima sin dejar que invente nada ni ejecute acciones que nadie aprobó. El alcance de este acelerador sale de un análisis de 12 ofertas de Upwork y 172 proyectos de clientes publicados por Databricks, guardado en el repositorio. En lugar de una propuesta, construí el producto que describen esas ofertas y lo ejecuté con datos públicos reales, para que un cliente vea el resultado antes de contratar. Es un proyecto personal, no un trabajo para un cliente, y no es un producto oficial de Databricks.
El producto en uso
Qué construí
Pipelines. Datos públicos reales de tres tipos de fuente (archivos en la nube, API HTTP y archivos locales, entre los ocho tipos de fuente admitidos) fluyen por bronce, plata y oro con PySpark y Delta, definidos en YAML y Spark SQL dentro de un pack. El ejecutor de trabajos es un proceso aparte, así que un trabajo que falla no puede tumbar la API. Los mismos pipelines corren en local o en un workspace de Databricks mediante el Asset Bundle incluido.
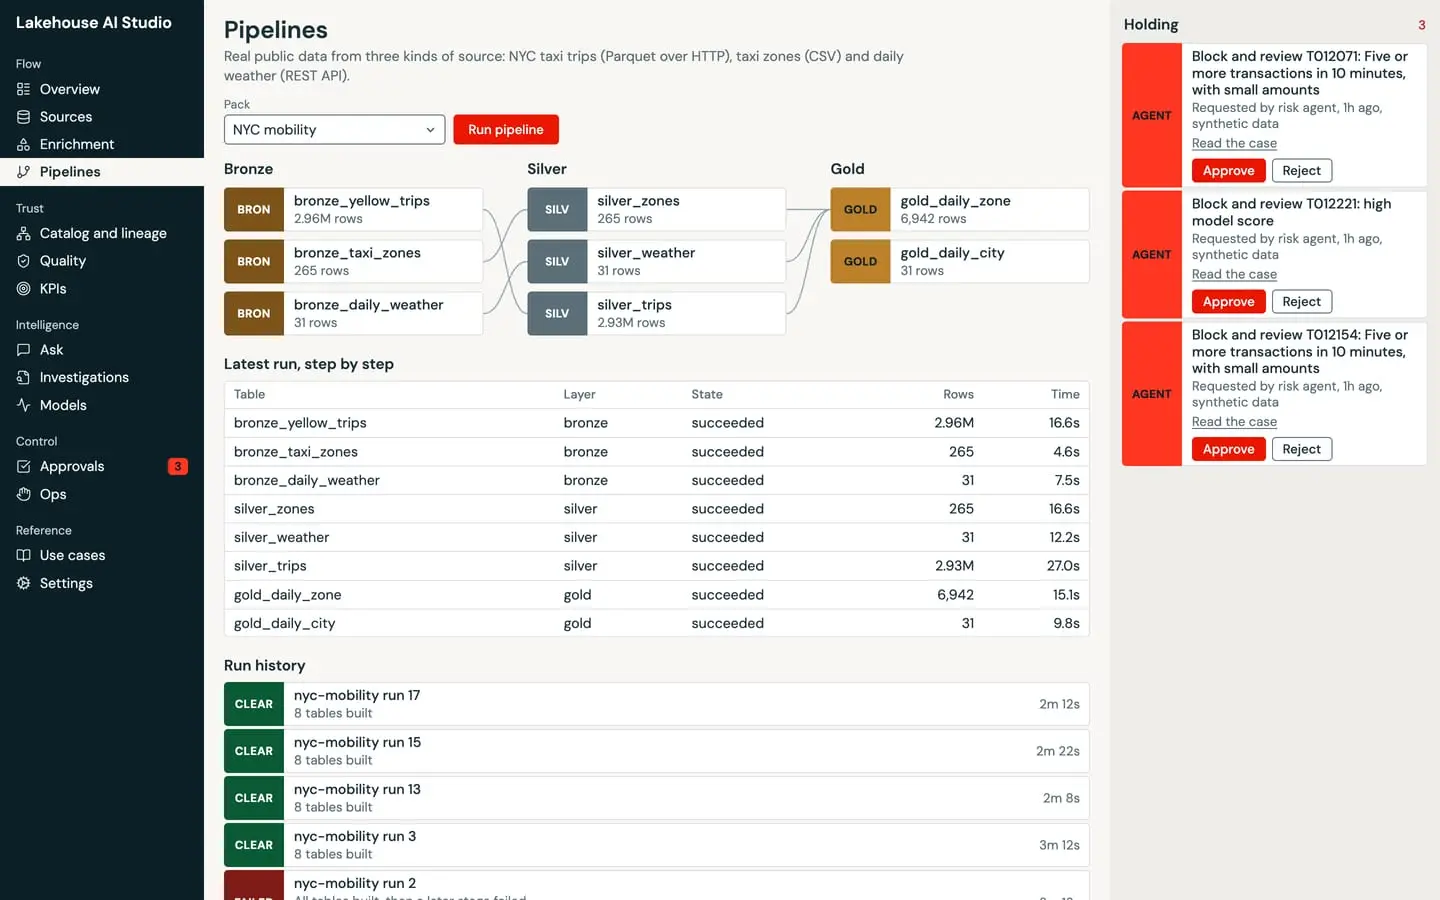
Calidad de datos. Las comprobaciones se ejecutan entre capas; unas 35.000 filas defectuosas de los 2,96 millones de viajes fueron a cuarentena en vez de a las cifras, y cada fila en cuarentena muestra por qué se retuvo. La conciliación da cuenta de cada fila y de cada dólar entre capas, y el linaje se registra por tabla a partir de las declaraciones del pack.
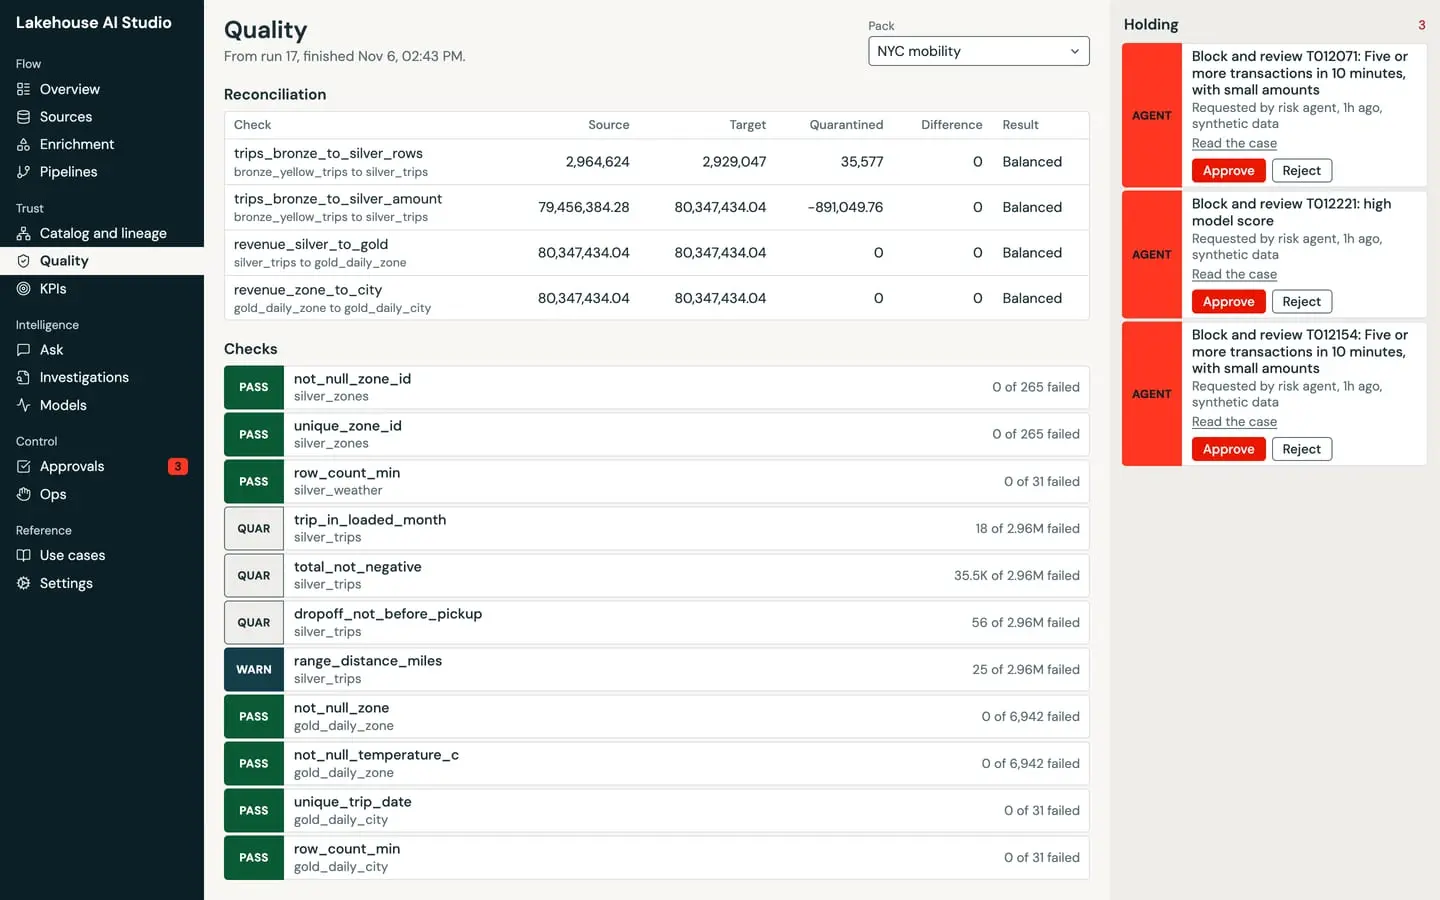
Ask. Una pregunta en lenguaje natural como «¿qué distrito tuvo más ingresos?» se responde con el resultado real y el SQL que hay detrás, generado solo sobre tablas oro y pasado por el guardián de SQL: solo lectura, solo tablas aprobadas, columnas de datos personales rechazadas, límite de filas forzado. Las preguntas sobre documentos («¿qué significa el tipo de pago 3?») se resuelven como RAG sobre PDF indexados en pgvector, y la respuesta abre su fuente.
Enriquecimiento híbrido. El pack fintech une transacciones locales con datos de referencia de tarjetas y ubicaciones extraídos de tablas de Databricks como instantáneas versionadas, muestra la tasa de coincidencia por fuente y bloquea los números de tarjeta completos en la ingesta, de modo que las filas bloqueadas nunca se almacenan. Las transacciones son sintéticas y las tablas de referencia se simulan hasta que se conecte un workspace, y la interfaz lo dice.
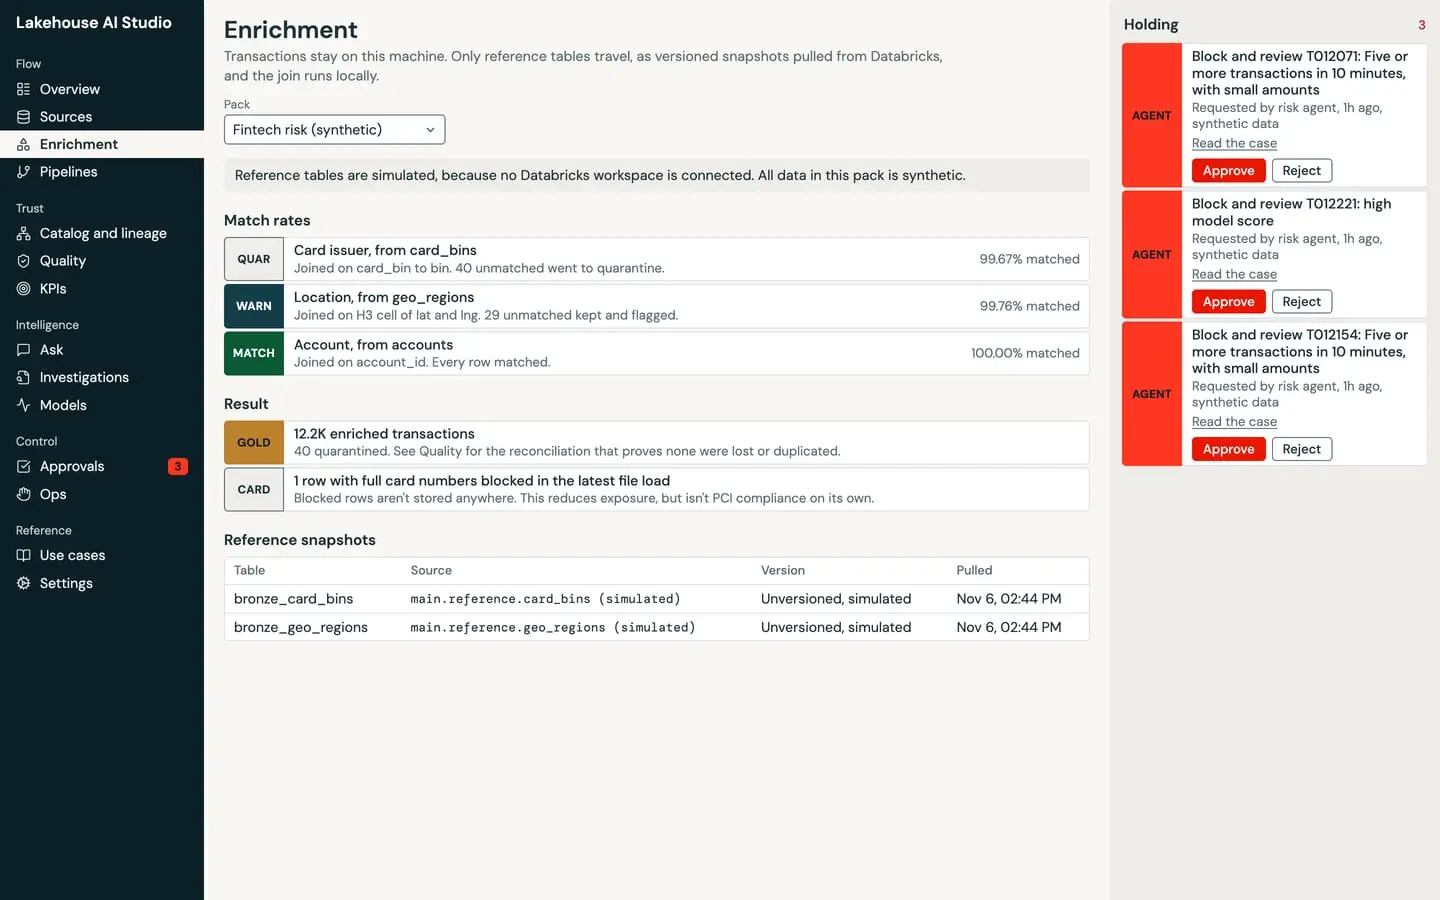
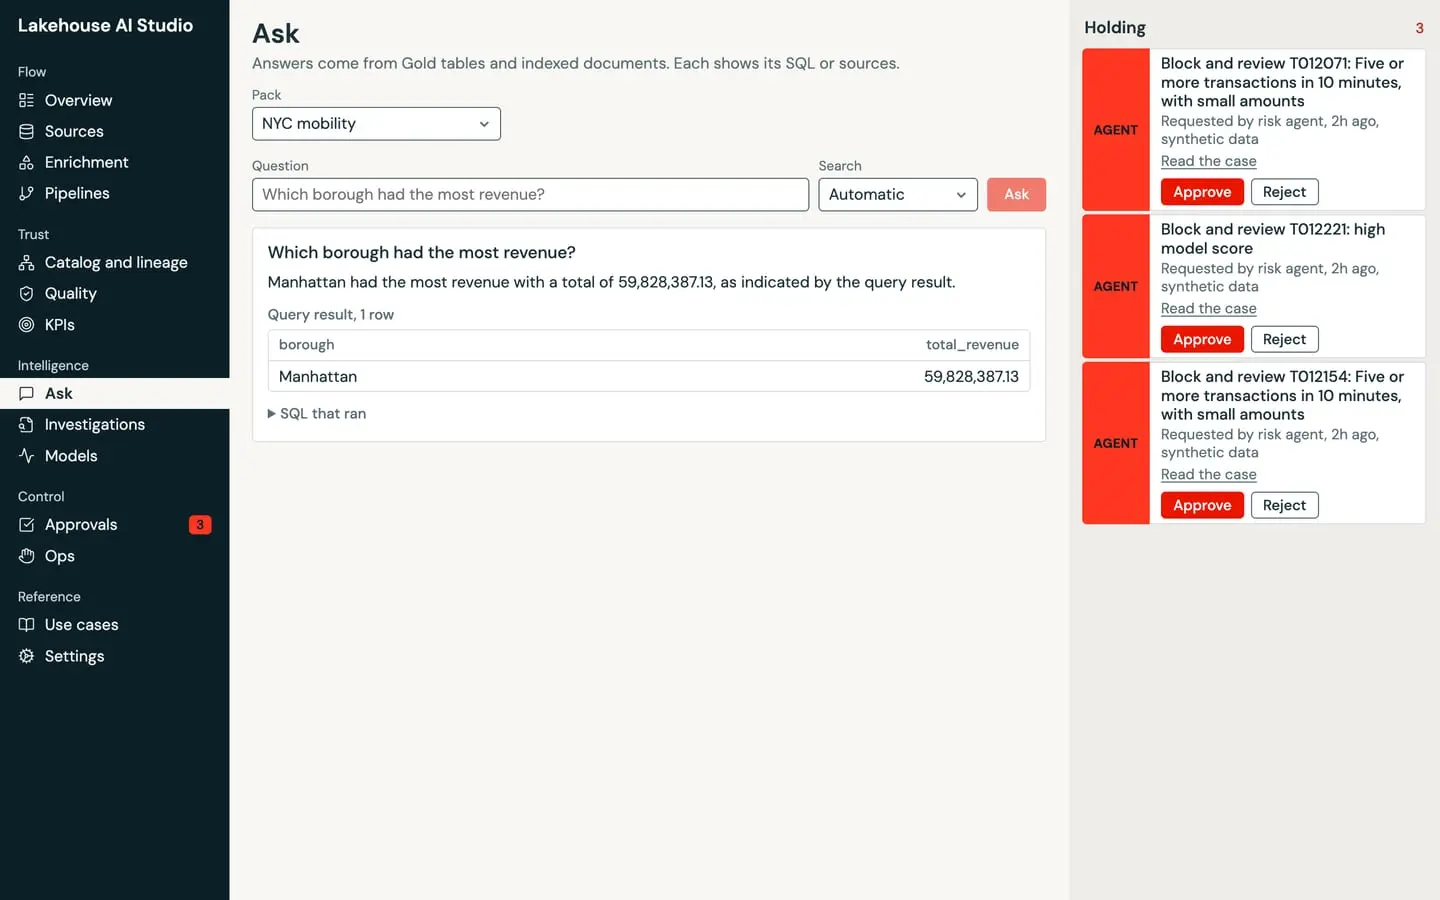
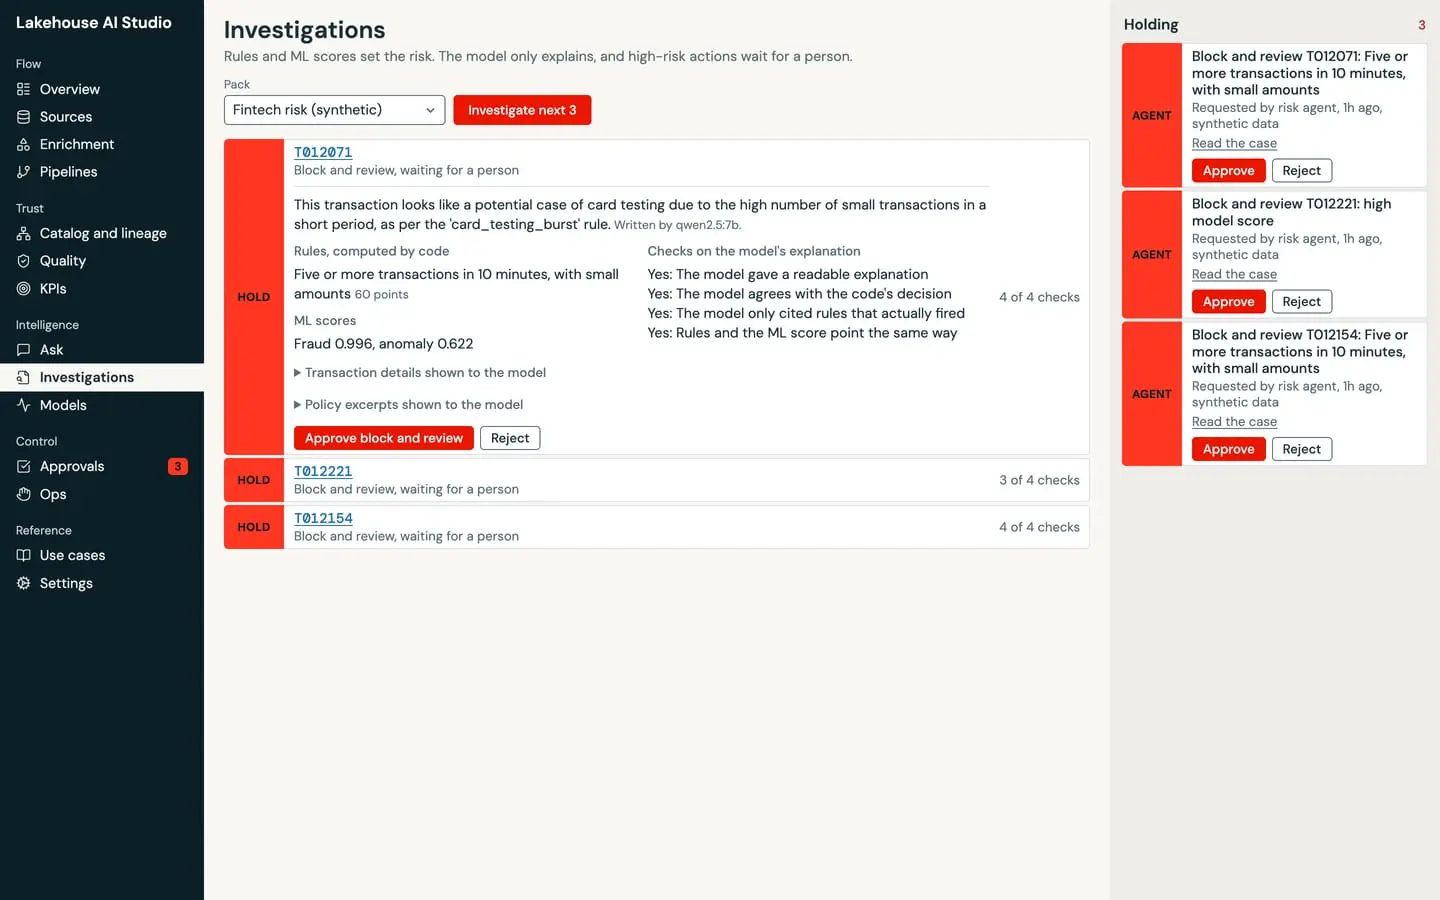
Agentes de IA con aprobación humana. Un flujo en LangGraph investiga cada caso de fraude: el código calcula las reglas, las puntuaciones y el nivel de riesgo, el modelo solo las explica, y las comprobaciones de confianza señalan cualquier desacuerdo entre ambos. Las acciones de alto riesgo van a una bandeja de aprobaciones; una persona aprueba o rechaza, y la decisión queda en un registro de auditoría que rechaza actualizaciones y borrados a nivel de base de datos.
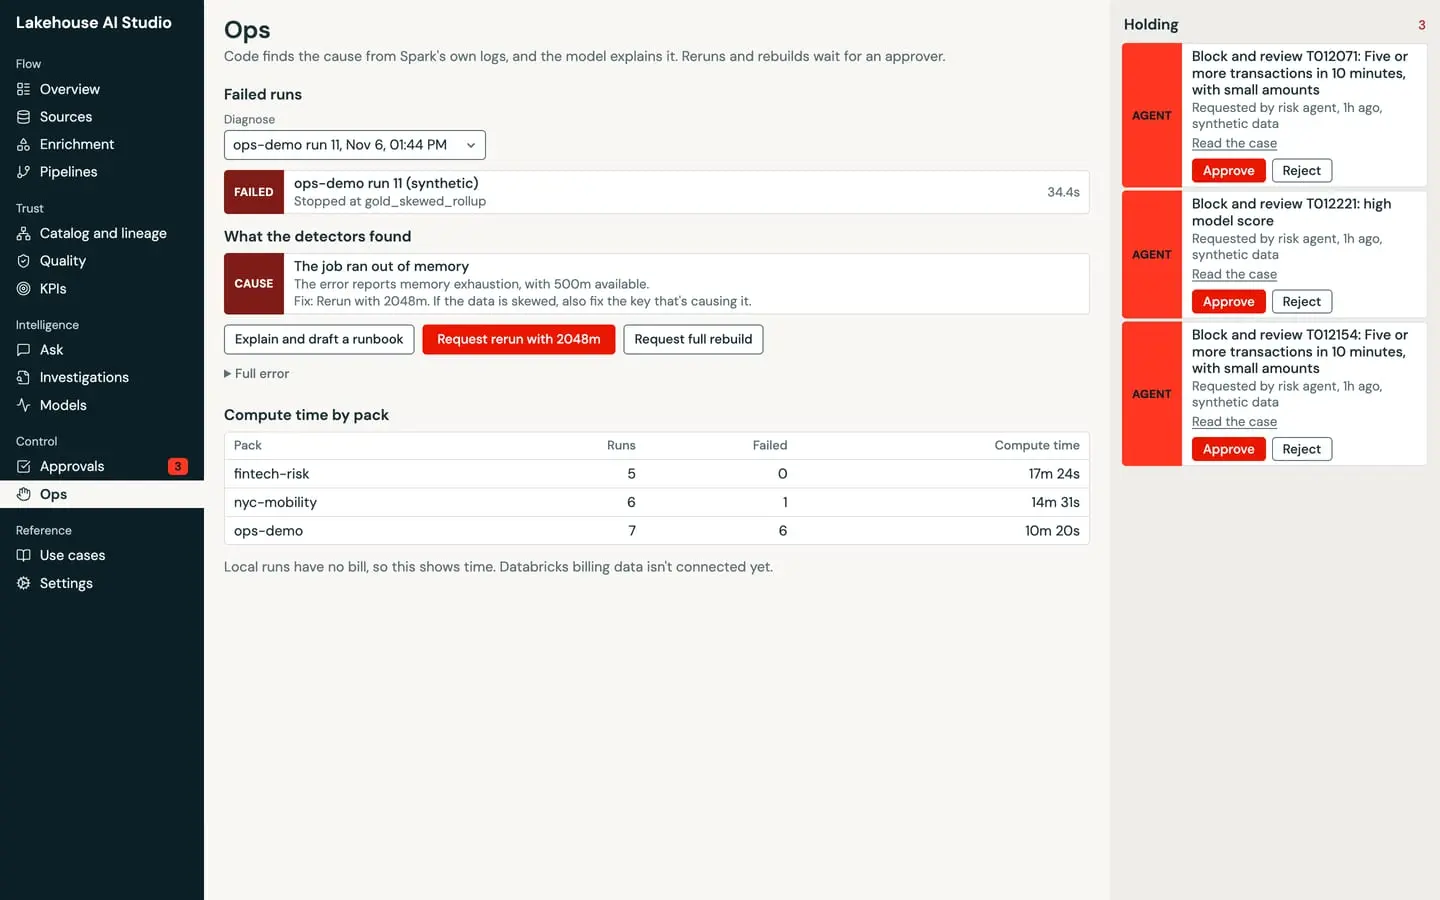
Diagnóstico de fallos. El pack de operaciones ejecuta un trabajo que de verdad se queda sin memoria. El copiloto de operaciones encuentra la causa en los logs de eventos de Spark, redacta un runbook y solicita una nueva ejecución; la nueva ejecución espera a un aprobador y después termina con éxito.
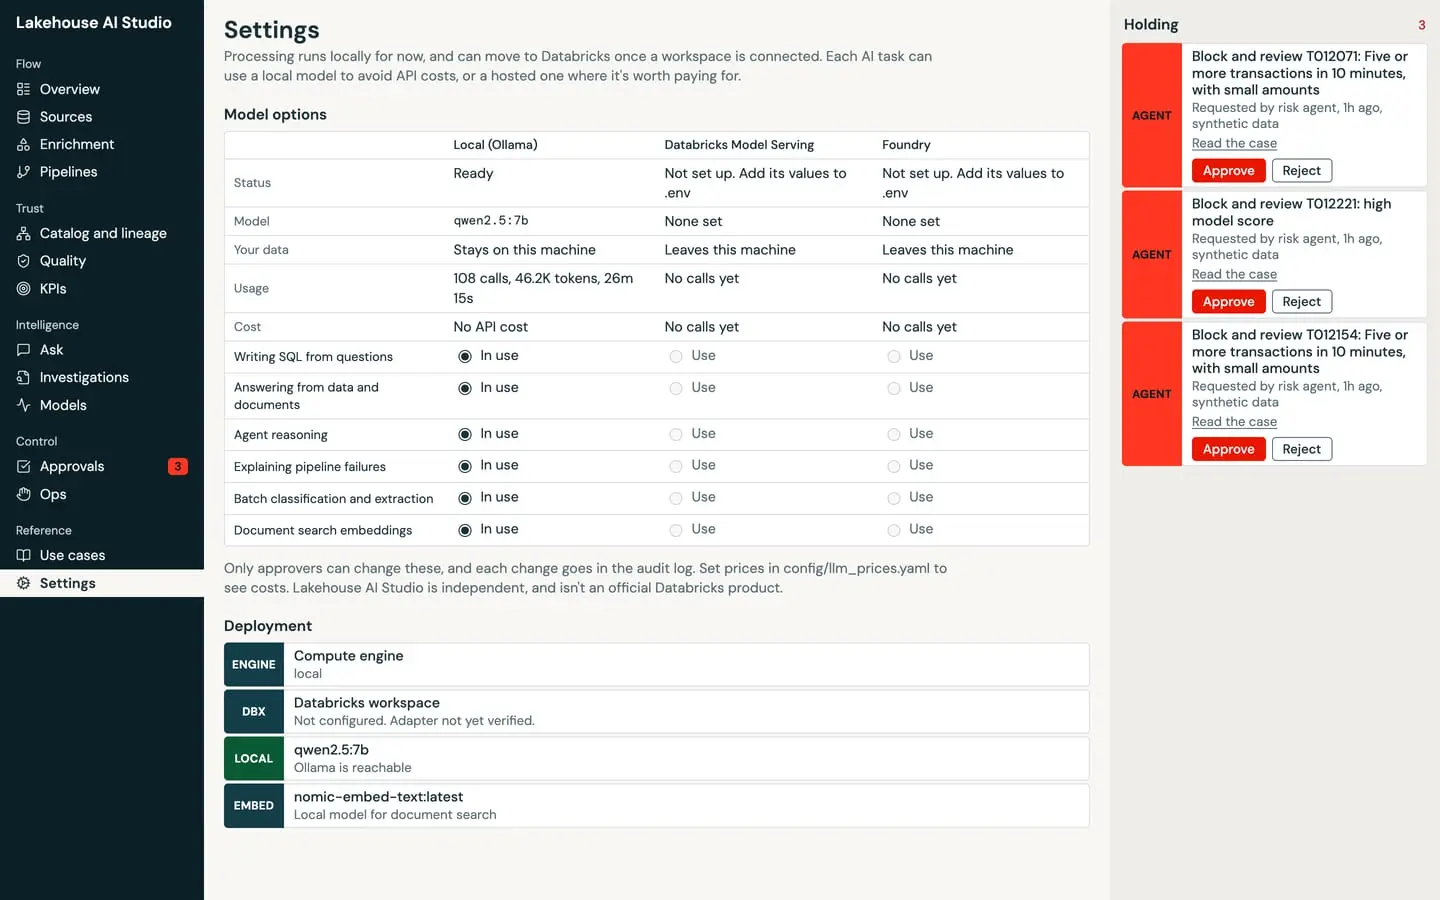
Opciones de modelo. Ajustes muestra una columna por opción de modelo, Ollama en local, Databricks Model Serving o Microsoft Foundry, con el uso por tarea. Un aprobador asigna un modelo a cada tarea, y enviar los datos de una tarea a un modelo alojado exige una confirmación explícita, de modo que el coste de API y la exposición de datos se deciden por tarea y no una sola vez para toda la plataforma.
Reglas de seguridad que el código impone
El código calcula reglas, puntuaciones y riesgo, y el modelo no puede rebajar un nivel de riesgo. Las acciones de alto riesgo, las nuevas ejecuciones, los backfills y las promociones de KPI esperan a un aprobador. El registro de auditoría rechaza actualizaciones y borrados a nivel de base de datos. Los números de tarjeta completos se bloquean en la ingesta, lo que reduce la exposición pero no es cumplimiento PCI por sí solo. Las columnas etiquetadas como datos personales son rechazadas por el guardián de SQL y enmascaradas en las muestras. Las consultas locales en DuckDB pueden leer el lago y nada más en la máquina. Cada respuesta de la IA muestra su SQL o sus fuentes, y los estados simulados, no verificados y obsoletos siempre están visibles en la interfaz.
Arquitectura
Las fuentes (archivos en la nube, HTTP, REST, JDBC, archivos locales, tablas de Databricks, Delta Shares, PDF) alimentan bronce, plata y oro, construidos con PySpark y Delta a partir del YAML y el Spark SQL de un pack, con comprobaciones, cuarentena, conciliación, linaje y bloqueo de números de tarjeta entre las capas. Las tablas oro alimentan el texto a SQL vigilado, las características oro alimentan el modelo de ML registrado en MLflow, y los documentos alimentan la búsqueda en pgvector; los tres alimentan a los agentes, que entregan las acciones trascendentes a la aprobación humana y al registro de auditoría. Un enrutador de modelos elige un proveedor por tarea, Ollama en local, Databricks Model Serving o Foundry, y registra cada llamada con sus tokens y su tiempo. Un frontend en React y TypeScript sobre Vite habla con un backend en FastAPI; Postgres con pgvector guarda el estado de la aplicación y el índice de documentos; el ejecutor de trabajos es un proceso aparte. Un make setup crea el entorno y los secretos, make api y make web lo arrancan, y make demo comprueba todo el recorrido de demostración contra una API en marcha.
Qué está verificado y qué no
El modo local está probado de extremo a extremo, con 88 tests de backend y evaluaciones de IA por pack. Los adaptadores de Databricks, Microsoft Foundry y Delta Sharing están construidos y probados solo contra simulaciones hasta que se conecten a servicios reales; el Databricks Asset Bundle se incluye pero todavía no se ha ejecutado en un workspace en vivo, y la interfaz marca el adaptador como no verificado hasta entonces. El streaming son microlotes sobre una carpeta, no hay fuente Kafka ni Event Hubs, y el linaje es a nivel de tabla a partir de las declaraciones del pack, no leído de Unity Catalog. Las empresas del catálogo de casos de uso son referencias de mercado de la publicación de la cumbre de Databricks, nunca clientes de este producto.
Proyectos relacionados
Snowflake AI Data Copilot: cifras fiables, IA y menos coste
Bases de datos e ingeniería de datos · IA y agentes · Cloud, DevOps y LLMOps
Azure AI Automation: Document Intelligence, RAG y agentes gobernados
IA y agentes · Cloud, DevOps y LLMOps · Bases de datos e ingeniería de datos
Chatbot RAG sobre regulación cripto (GPT-4 + Pinecone)
IA y agentes · Bases de datos e ingeniería de datos · Cloud, DevOps y LLMOps