
IA y agentes · Bases de datos e ingeniería de datos · Cloud, DevOps y LLMOps
Chatbot RAG sobre regulación cripto (GPT-4 + Pinecone)
Por David Gadyan · Publicado el · Actualizado el
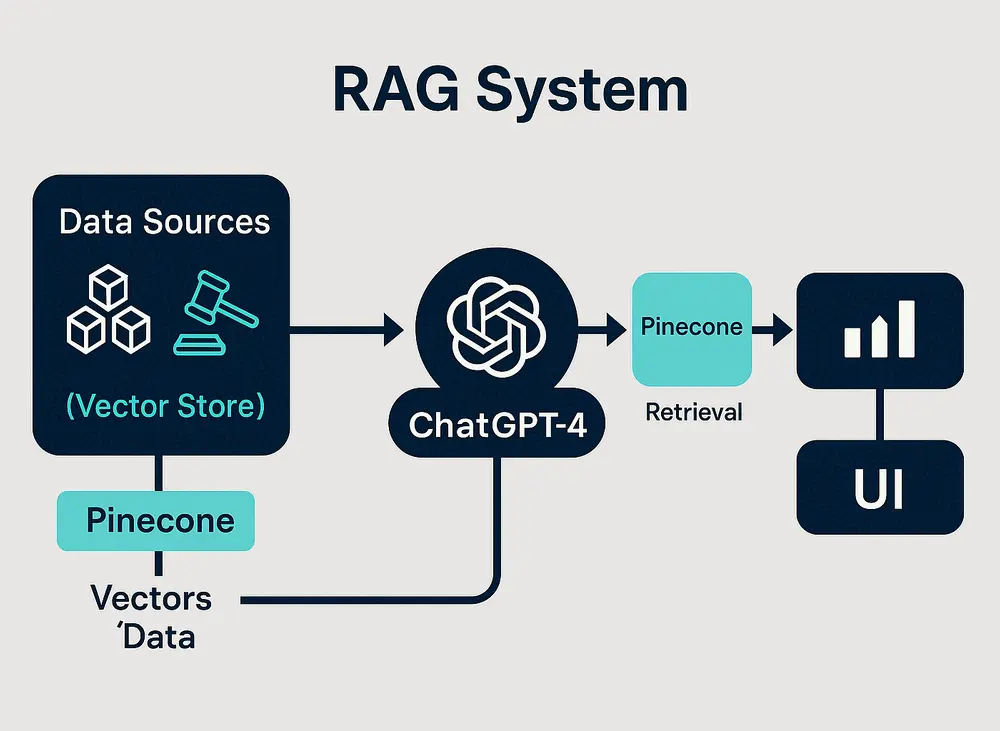
Asistente de investigación RAG sobre la regulación de blockchain y criptoactivos de 2024 en varias jurisdicciones. Pipelines en LangChain convierten PDF, CSV, HTML y texto plano en vectores dentro de una base de datos vectorial Pinecone, GPT-4 responde preguntas legales por jurisdicción con citas de las fuentes en una interfaz Streamlit, y todo se entrega con configuración Docker y scripts de despliegue para que otros equipos lo adapten.
El problema
La regulación de blockchain y criptoactivos cambió deprisa en 2024 y varía según la jurisdicción, y las fuentes primarias están repartidas entre PDF escaneados, tablas CSV, páginas HTML de sitios como Global Legal Insights y notas en texto plano. Responder a una sola pregunta obligaba a leerlas todas y aun así no quedaba claro de qué documento salía cada afirmación. El objetivo era un chatbot que respondiera preguntas legales por jurisdicción en segundos y mostrara la fuente de cada respuesta.
Qué construí
- Un backend en LangChain que convierte los textos legales y regulatorios en vectores y los indexa en Pinecone para recuperarlos en menos de un segundo.
- GPT-4 como modelo de generación, con prompts que combinan el contexto recuperado con la pregunta del usuario para que las respuestas se apoyen en la normativa indexada.
- Un frontend en Streamlit: una interfaz conversacional donde el usuario plantea preguntas por jurisdicción y ve las citas de las fuentes en línea.
- Pipelines de ingesta para PDF, CSV, HTML y texto plano, con OCR automático para PDF escaneados, análisis de tablas CSV y web scraping de HTML desde Global Legal Insights.
- Ajuste de la base de datos vectorial: dimensiones de los embeddings y parámetros del índice de Pinecone elegidos para un almacenamiento económico y búsquedas por similitud rápidas a escala.
- Empaquetado con scripts de despliegue, configuración Docker y un README, además de una capa de conectores pensada para añadir bases de datos, API o fuentes en streaming con cambios mínimos de código.
Datos e infraestructura
La capa de recuperación es lo que hace fiables las respuestas. Cada documento se vectoriza y se guarda en Pinecone junto con su referencia de origen, que es lo que permite a la interfaz citar de dónde sale cada pasaje. Ajustar las dimensiones de los embeddings y los parámetros del índice mantuvo bajo el coste de almacenamiento sin ralentizar la búsqueda por similitud. La aplicación corre en Streamlit Cloud, y la configuración Docker y los scripts permiten que un equipo la despliegue igualmente en su propia infraestructura.
Resultado
Recuperación en menos de un segundo sobre el corpus regulatorio, ingesta multiformato con OCR y una cita en línea en cada respuesta. Como la solución se entrega como un paquete documentado y en contenedores, con una capa de conectores ampliable, otros equipos pueden apuntarla a sus propios documentos legales o de políticas en lugar de empezar de cero.
Proyectos relacionados
Motor de lead scoring y detección de churn con IA (S1mple.ai)
ERP y SaaS con IA · IA y agentes · Marketing con IA y analítica · Bases de datos e ingeniería de datos
Virgil.ai: asistente agéntico de seguros de salud
IA y agentes · ERP y SaaS con IA · Cloud, DevOps y LLMOps · Seguridad y cumplimiento
Generación de texto multilingüe: fine-tuning de Mistral 7B y API
IA y agentes · Cloud, DevOps y LLMOps