
Bases de datos e ingeniería de datos · IA y agentes · Cloud, DevOps y LLMOps
Snowflake AI Data Copilot: cifras fiables, IA y menos coste
Por David Gadyan · Publicado el · Actualizado el
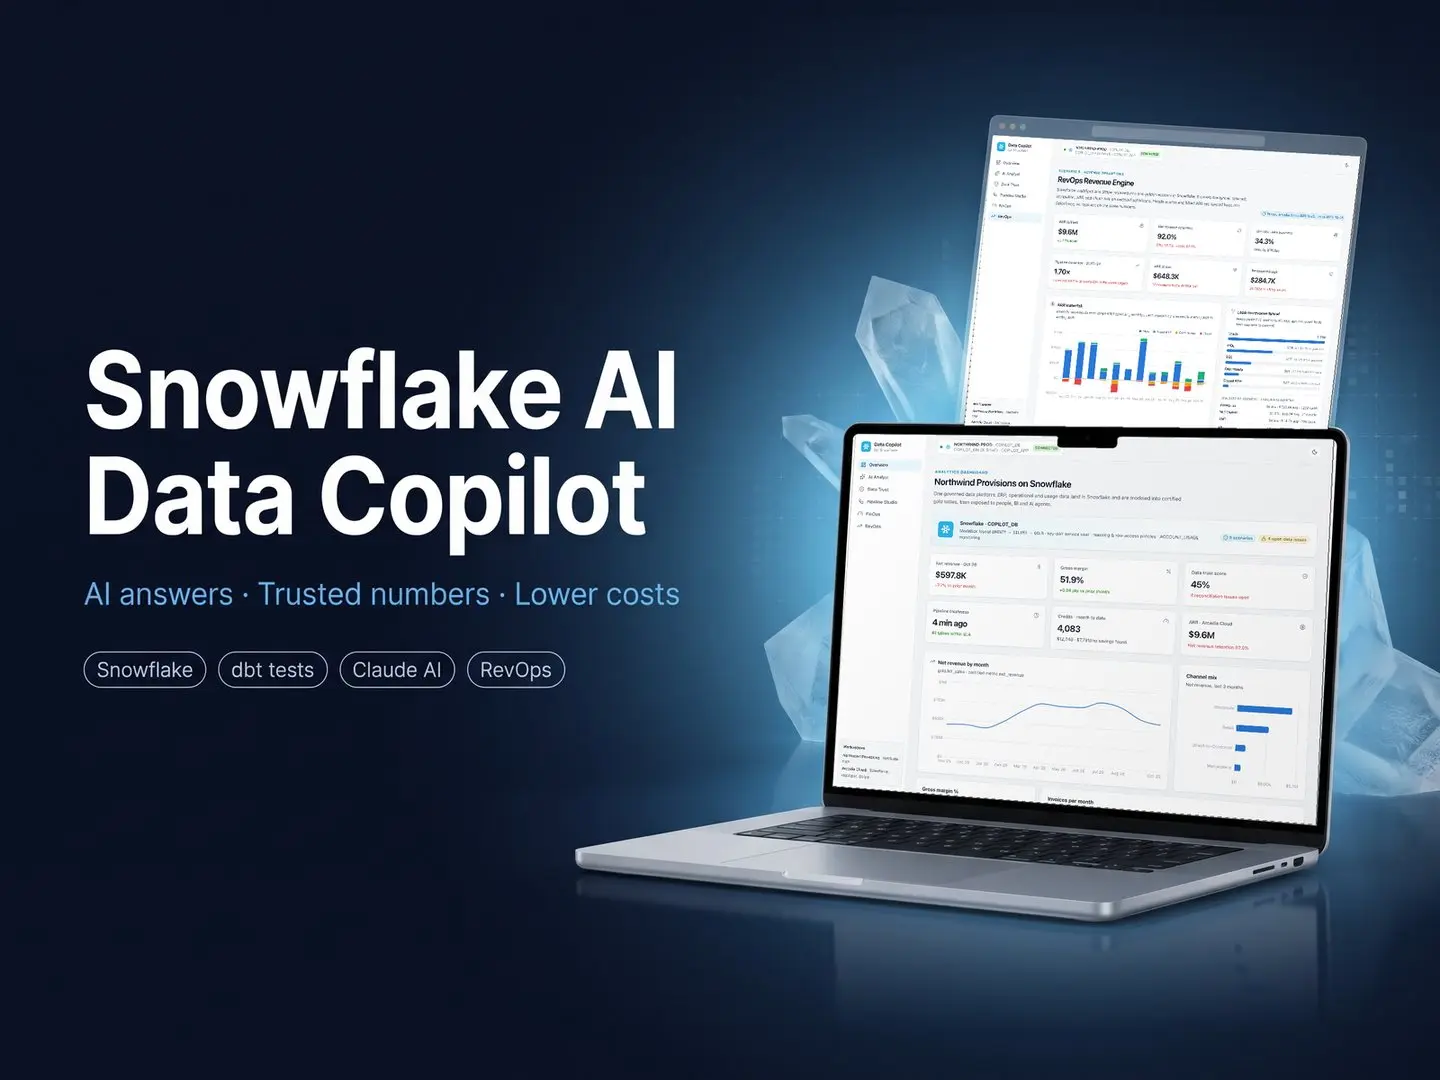
Una plataforma de datos Snowflake + IA, ejecutable, construida en torno a los cinco problemas por los que más se contrata a especialistas en Snowflake: un AI Analyst que escribe SQL gobernado a partir de métricas certificadas, una conciliación entre el almacén y NetSuite que explica cada dólar de diferencia, pipelines incrementales que se detienen con seguridad ante un cambio de esquema incompatible, un centro FinOps con ahorros ordenados y un simulador what-if, y un motor RevOps que une Salesforce, HubSpot y Stripe. FastAPI, DuckDB organizado como una cuenta de Snowflake, Next.js, el mismo diseño en DDL de Snowflake, 48 tests.
El problema
Las mismas cinco peticiones dominan las ofertas de trabajo de Snowflake: «¿qué cifra es la correcta? El informe no cuadra con NetSuite», «nuestro asistente de IA consulta siempre la tabla equivocada», «el pipeline se rompió y nadie se dio cuenta en tres días», «¿por qué es tan alta la factura de Snowflake?» y «ventas, marketing y facturación muestran ingresos distintos». El estudio de mercado detrás de esa lista está en el repositorio. En lugar de cinco propuestas, construí un producto que responde a las cinco, para que un cliente vea el resultado antes de contratar: un SaaS de demostración con dos inquilinos (Northwind Provisions sobre NetSuite y datos operativos, Arcadia Cloud sobre Salesforce, HubSpot y Stripe), sembrado de forma determinista para que cada cifra de cada pantalla sea salida real de la aplicación en marcha.
El producto en uso
Qué construí
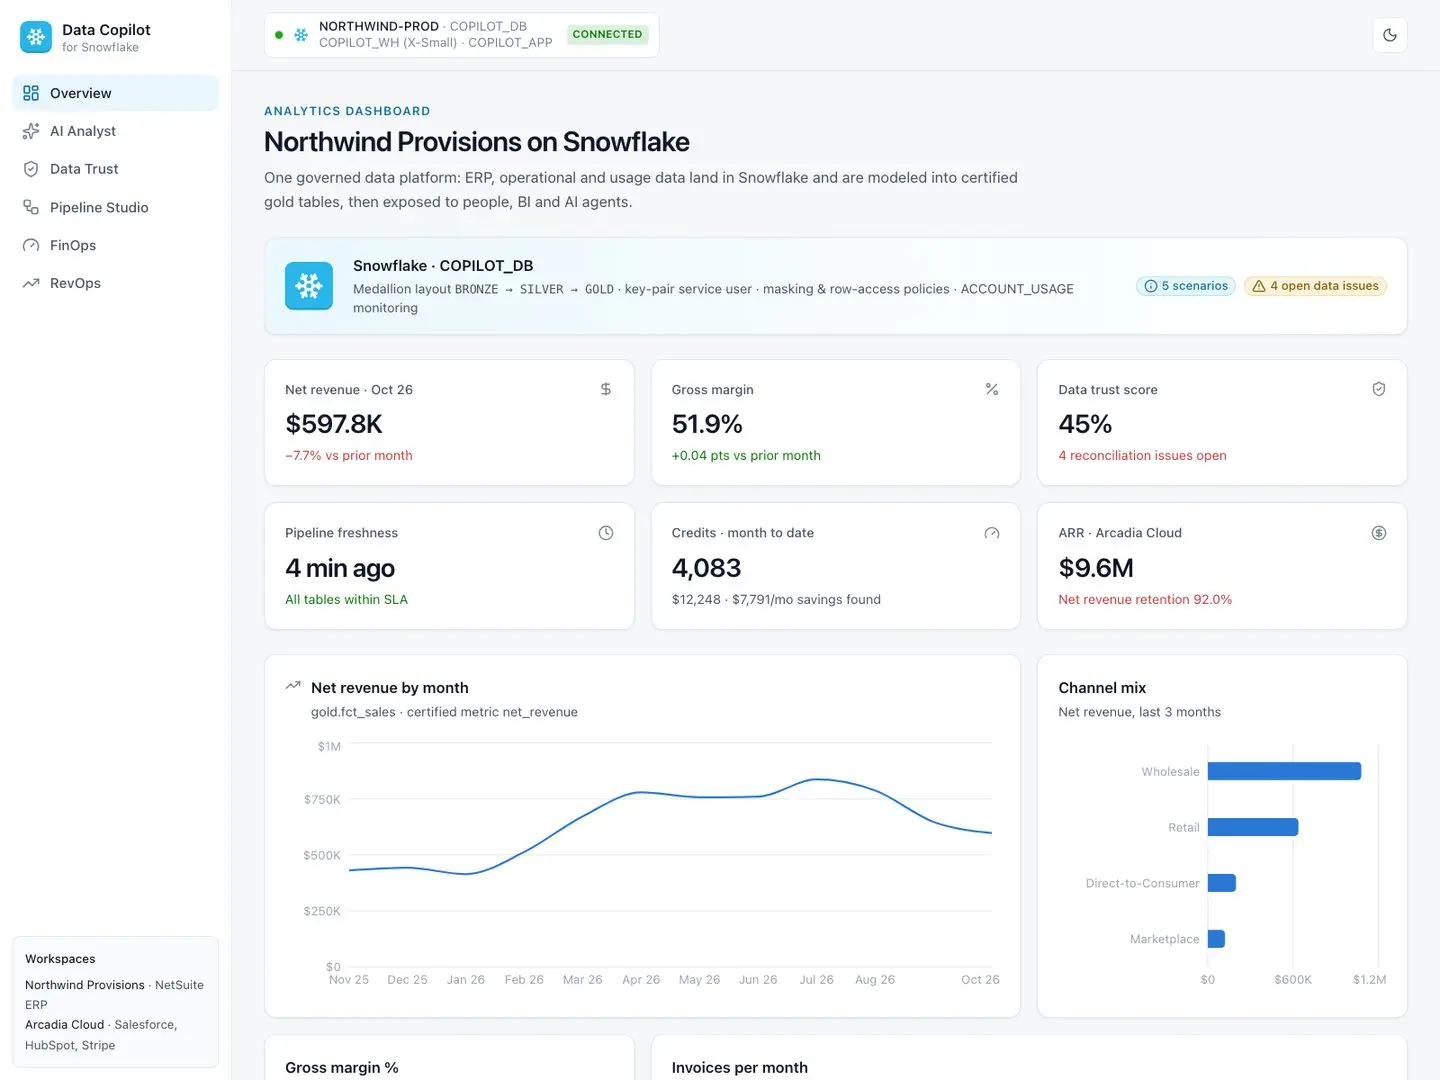
AI Analyst. Cualquiera puede preguntar en lenguaje natural («¿Quiénes son nuestros 10 mejores clientes?») y obtener la respuesta, un gráfico y el SQL exacto que hay detrás. Claude escribe el SQL solo a partir de un modelo semántico de métricas certificadas y consultas verificadas (la misma idea que el repositorio de consultas verificadas de Cortex Analyst), así que «ingresos» significa lo mismo cada vez. Al cambiar de rol se ve la columna de correo enmascarada, las filas limitadas a una región y tablas bloqueadas, reflejo de las políticas MASK_EMAIL y RAP_REGION del DDL de Snowflake. Sin clave de API, el analista responde a las ocho preguntas de ejemplo verificadas; con ella acepta cualquier pregunta.
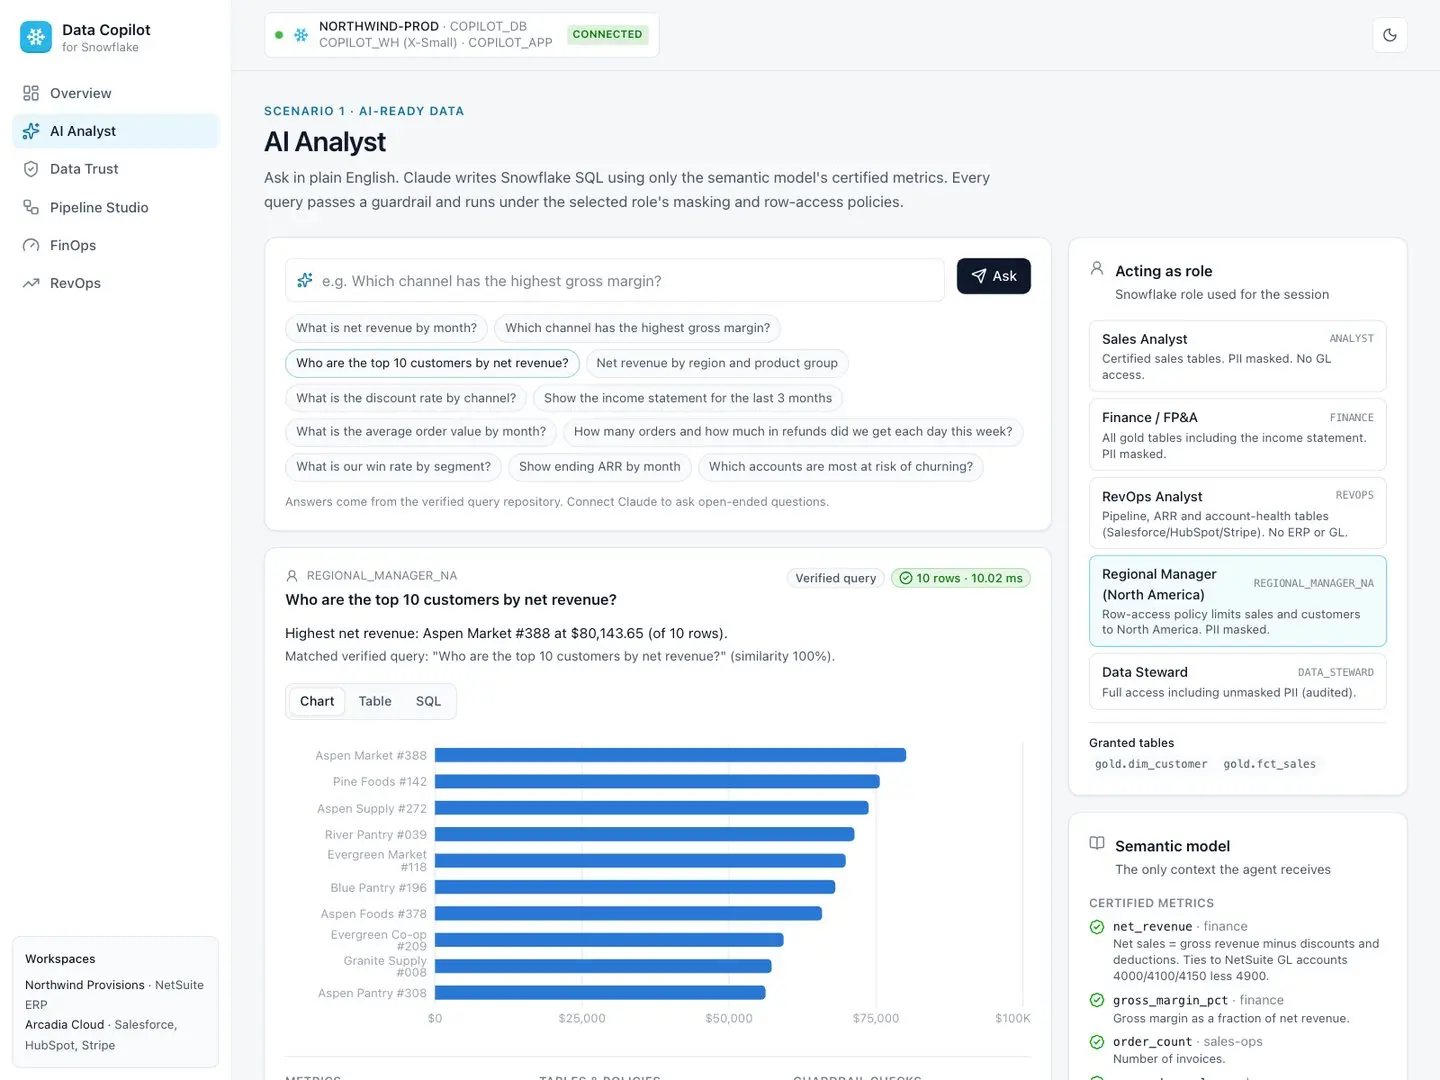
Confianza en los datos y conciliación. Un cuadre mes a mes de la cuenta de resultados del almacén contra NetSuite con cuatro defectos sembrados: un join duplicado, una fuga de borrados lógicos, un desplazamiento de periodo por zona horaria y una cuenta sin mapear. El 100 % de la diferencia se atribuye a esos defectos, los tests al estilo dbt detectan cada uno y un arreglo en un clic reconstruye los modelos, de modo que finanzas puede firmar las cifras en vez de discutirlas.
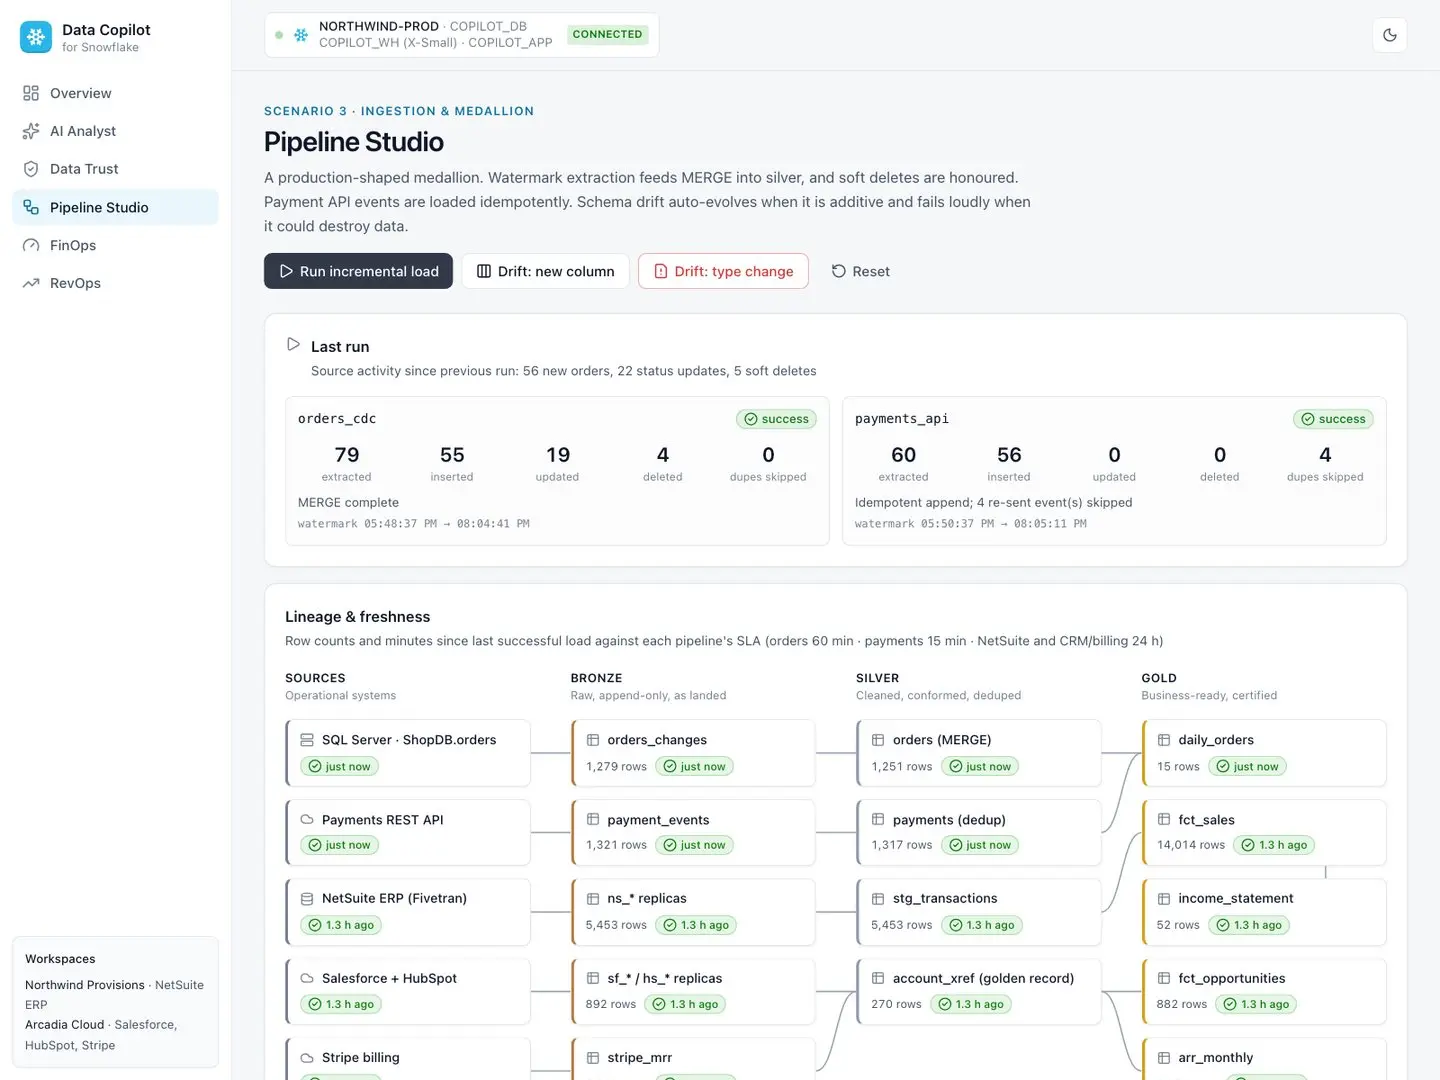
Pipeline Studio. Bronce, plata y oro con cargas incrementales por marca de agua + MERGE, borrados lógicos, una carga de API idempotente, SLA de frescura e historial de ejecuciones. La deriva aditiva del esquema evoluciona el destino automáticamente; un cambio de tipo incompatible falla de forma visible y retiene la marca de agua en lugar de llenar los informes de datos malos sin avisar.
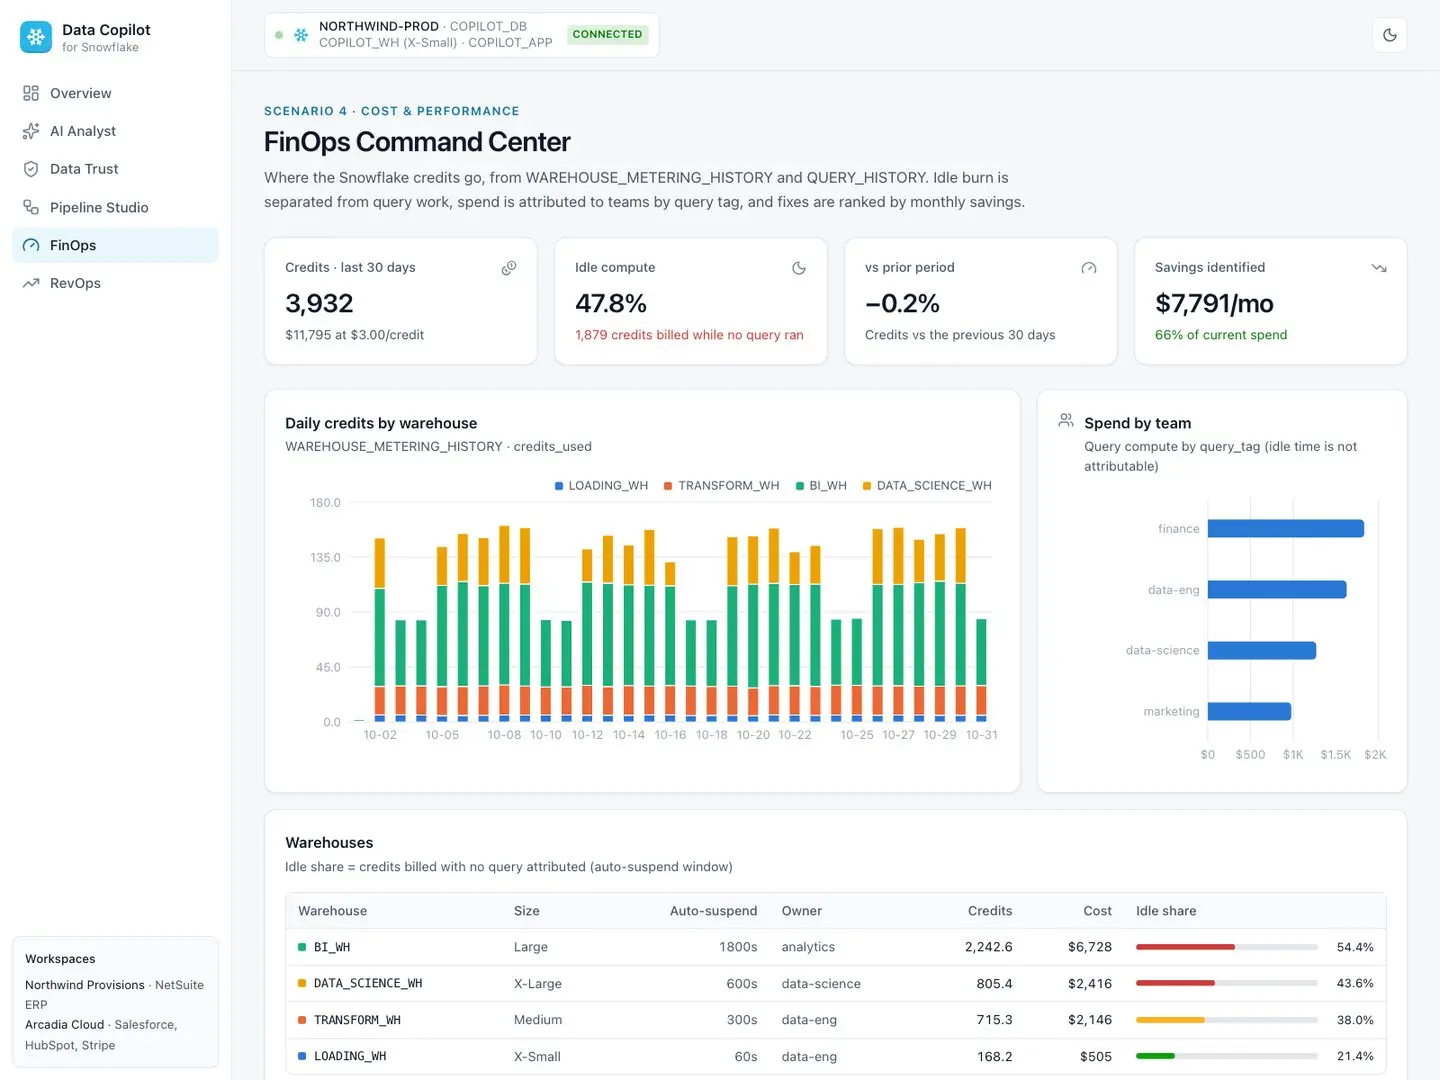
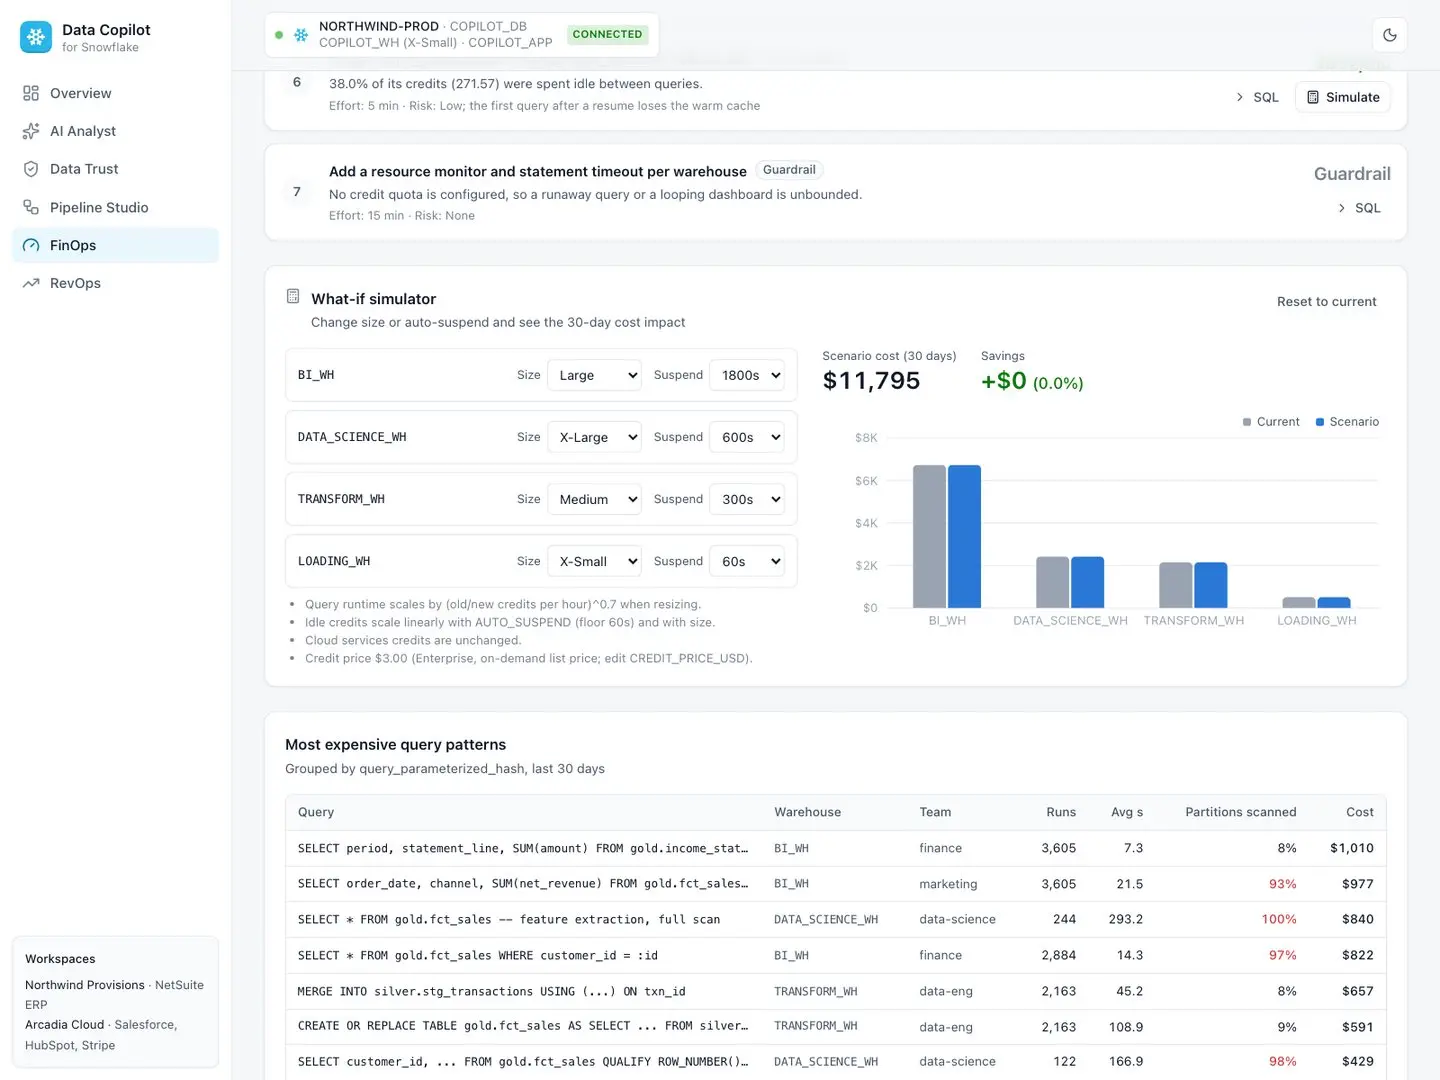
Centro de mando FinOps. Créditos por warehouse y equipo, consumo en reposo, los patrones de consulta más caros y recomendaciones ordenadas por ahorro mensual (unos 7.800 $ al mes en el conjunto de demostración). Un simulador what-if muestra el efecto de un warehouse más pequeño o de un auto-suspend más corto sobre el coste y la velocidad antes de tocar nada en producción. Las consultas equivalentes contra las vistas reales de ACCOUNT_USAGE se entregan con el repositorio.
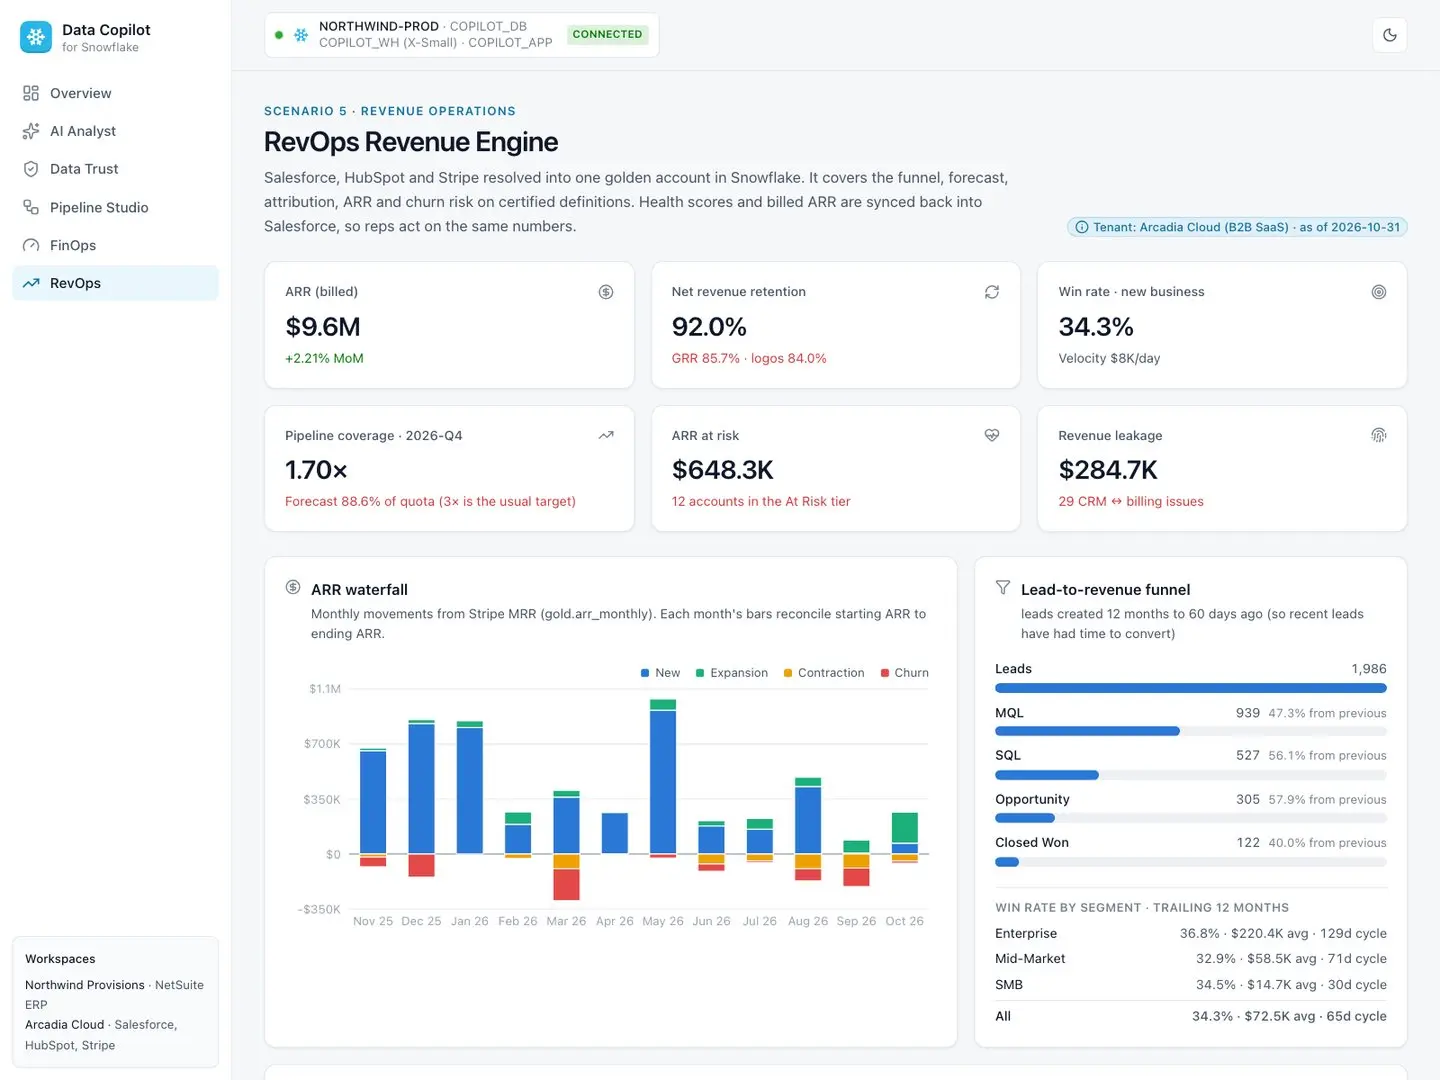
Motor de ingresos RevOps. El segundo inquilino une Salesforce, HubSpot y Stripe en una cuenta maestra por dominio y alimenta el embudo de lead a ganado, la previsión y cobertura del trimestre, la atribución first-touch, last-touch, lineal y en W con ROAS, la cascada de ARR, NRR y GRR y el riesgo de abandono. Las comprobaciones CRM frente a facturación encuentran duplicados, fugas de ingresos (operaciones ganadas nunca facturadas), ARR sin seguimiento y descuadres de reservas, y un reverse ETL basado en diferencias escribe la puntuación de salud y el ARR facturado de vuelta en Salesforce.
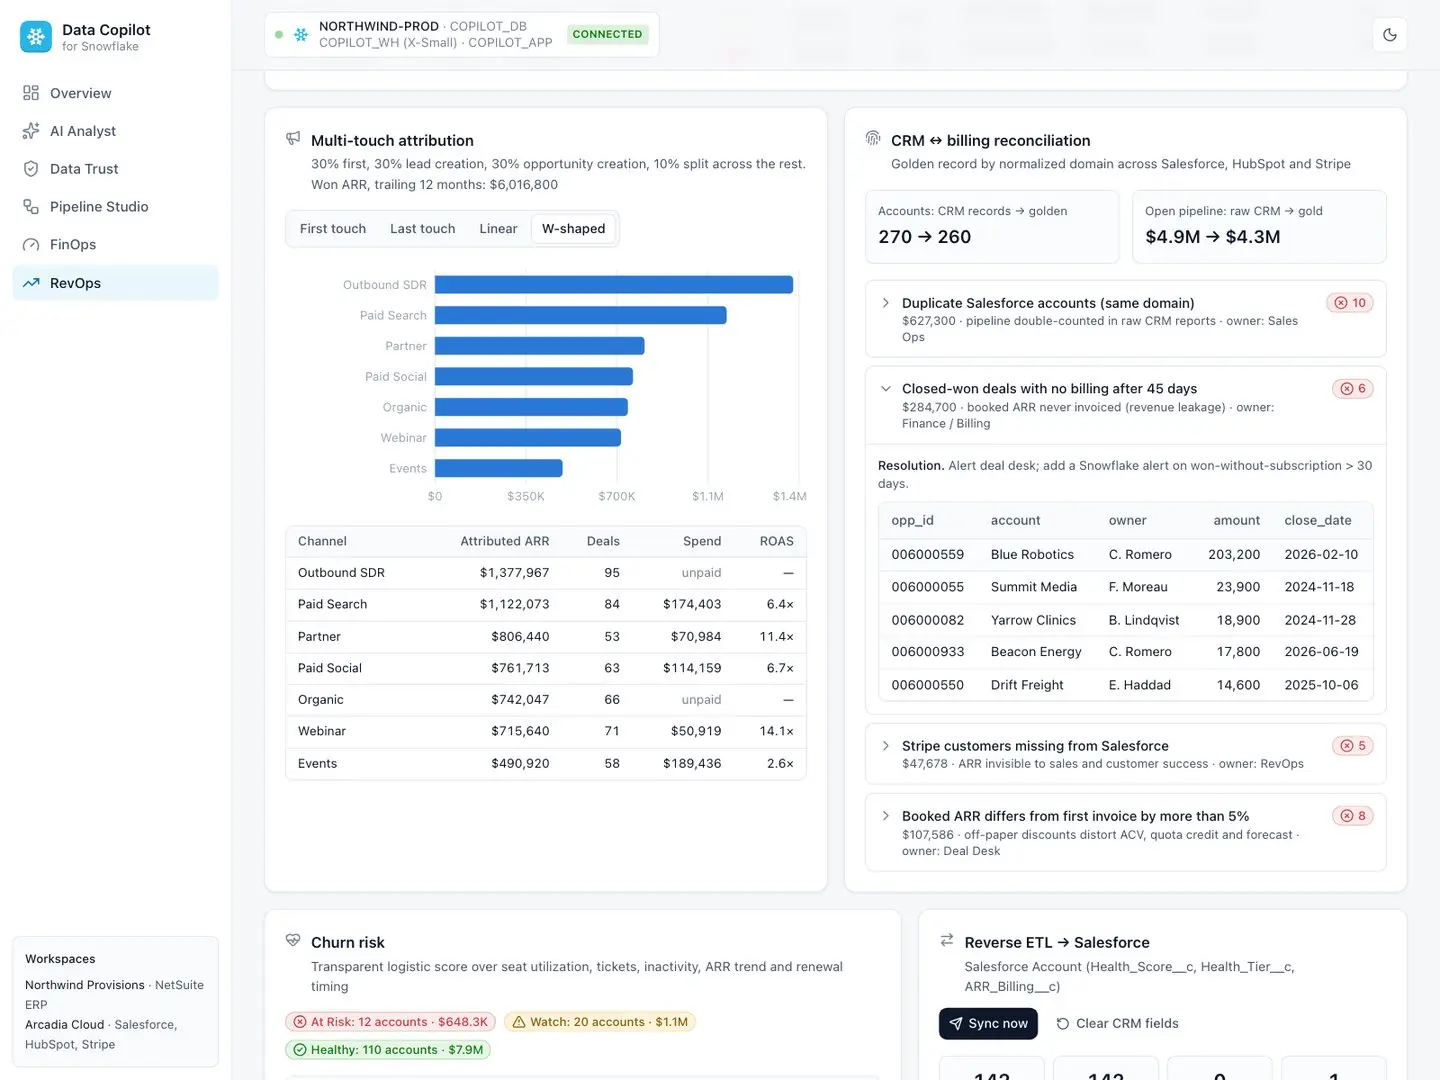
Barreras para el SQL generado por IA
Cada consulta que produce el analista pasa por seis comprobaciones, en orden, antes de ejecutarse: el SQL se analiza con sqlglot y debe ser exactamente una sentencia de solo lectura; no hay DDL ni DML en ningún punto del árbol ni funciones de archivo o de tablas del sistema; cada tabla debe estar concedida al rol activo, con los nombres sin esquema resueltos a través del modelo semántico; las tablas gobernadas se reescriben como subconsultas de política que enmascaran la columna de correo y aplican el filtro de región; se añade un LIMIT 1000 y la consulta se transpila al dialecto del motor; y en modo demostración la propia conexión DuckDB tiene desactivado el acceso a archivos externos y a la red.
Arquitectura
Un front end en Next.js 14 (TypeScript, Tailwind, Recharts) redirige las llamadas a la API a un backend FastAPI. Una interfaz de motor de almacén corre sobre DuckDB organizado como una cuenta de Snowflake (esquemas bronze, silver, gold y account_usage) en modo demostración, o sobre el conector de Snowflake en modo en vivo, donde las políticas nativas aplican el enmascarado. El módulo de semilla construye datos deterministas de NetSuite, operativos y de uso en unos 20 segundos en el primer arranque, sin credenciales; encima se apoyan el modelo semántico (tablas, métricas certificadas, consultas verificadas), el módulo de seguridad (roles, políticas de enmascarado y de acceso por fila), la barrera SQL y los cinco módulos de escenario. El mismo diseño se entrega como DDL real de Snowflake: base de datos y warehouses, roles de mínimo privilegio y un usuario de servicio con par de claves, políticas de enmascarado y de acceso por fila, la tarea MERGE incremental, la vista semántica, las consultas FinOps contra ACCOUNT_USAGE y el modelo RevOps. Respaldado por 48 tests de backend y una comprobación de TypeScript; un make dev o docker compose up lo arranca.
Proyectos relacionados
Azure AI Automation: Document Intelligence, RAG y agentes gobernados
IA y agentes · Cloud, DevOps y LLMOps · Bases de datos e ingeniería de datos
Chatbot RAG sobre regulación cripto (GPT-4 + Pinecone)
IA y agentes · Bases de datos e ingeniería de datos · Cloud, DevOps y LLMOps
Motor de lead scoring y detección de churn con IA (S1mple.ai)
ERP y SaaS con IA · IA y agentes · Marketing con IA y analítica · Bases de datos e ingeniería de datos