
IA y agentes · Cloud, DevOps y LLMOps · Bases de datos e ingeniería de datos
Azure AI Automation: Document Intelligence, RAG y agentes gobernados
Por David Gadyan · Publicado el
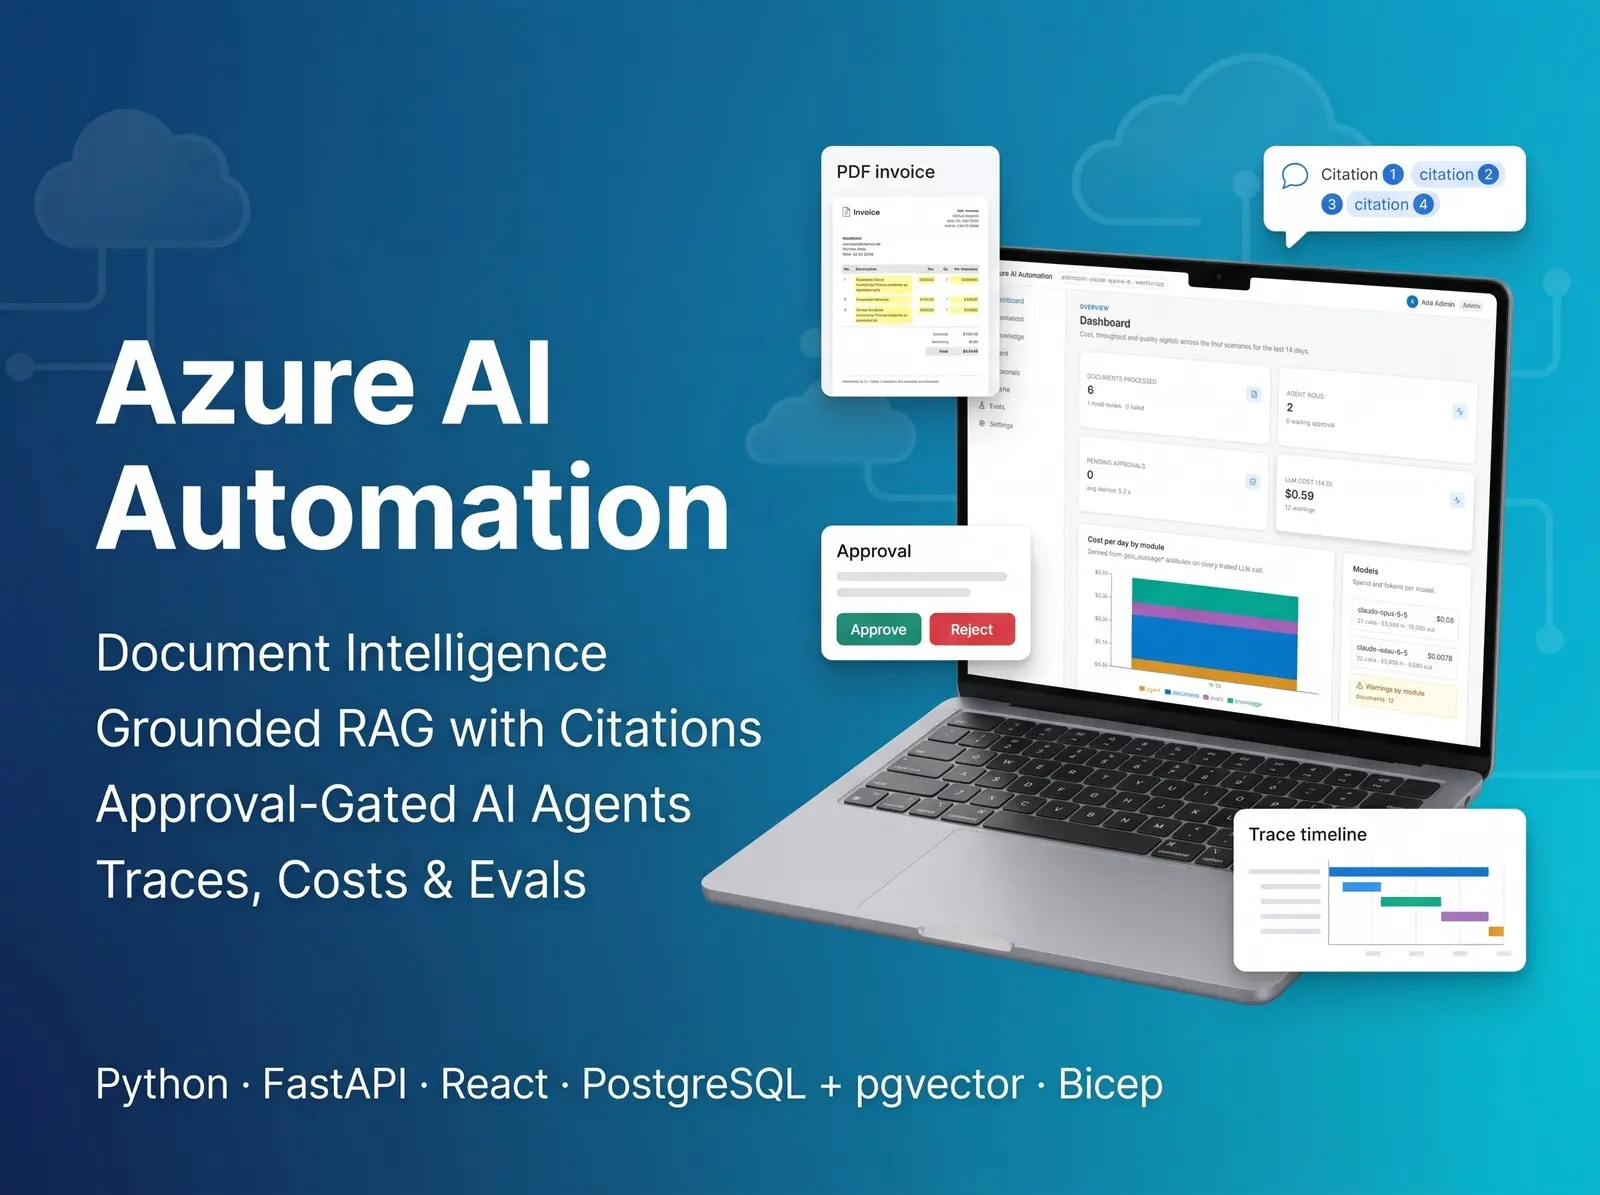
Plataforma integral de Azure y LLM para el back office de construcción e industria. Convierte PDF desordenados en datos validados citando la fuente de cada campo, responde a las preguntas del equipo solo con documentos de la empresa y con citas, y ejecuta un agente de IA cuyas acciones de escritura esperan siempre la aprobación de una persona. Cada llamada se traza y se costea, y las versiones de prompts se miden con conjuntos de referencia. En inglés y alemán.
El problema
Los equipos que intentan conectar los servicios de IA de Azure con operaciones reales chocan con los mismos muros: muchos servicios que orquestar (Document Intelligence, Blob, colas, búsqueda y el modelo), estado que debe sobrevivir a pasos asíncronos y aprobaciones humanas, llamadas a herramientas que rompen el bucle del agente, requisitos de cumplimiento (RGPD, auditoría, identidad) y ninguna forma de saber si un cambio de prompt mejoró o empeoró las respuestas.
La plataforma está pensada para el back office de construcción e industria, donde el papeleo son facturas de proveedores, informes de inspección, certificados de material y planos, en inglés y alemán.
El producto en uso
Qué construí
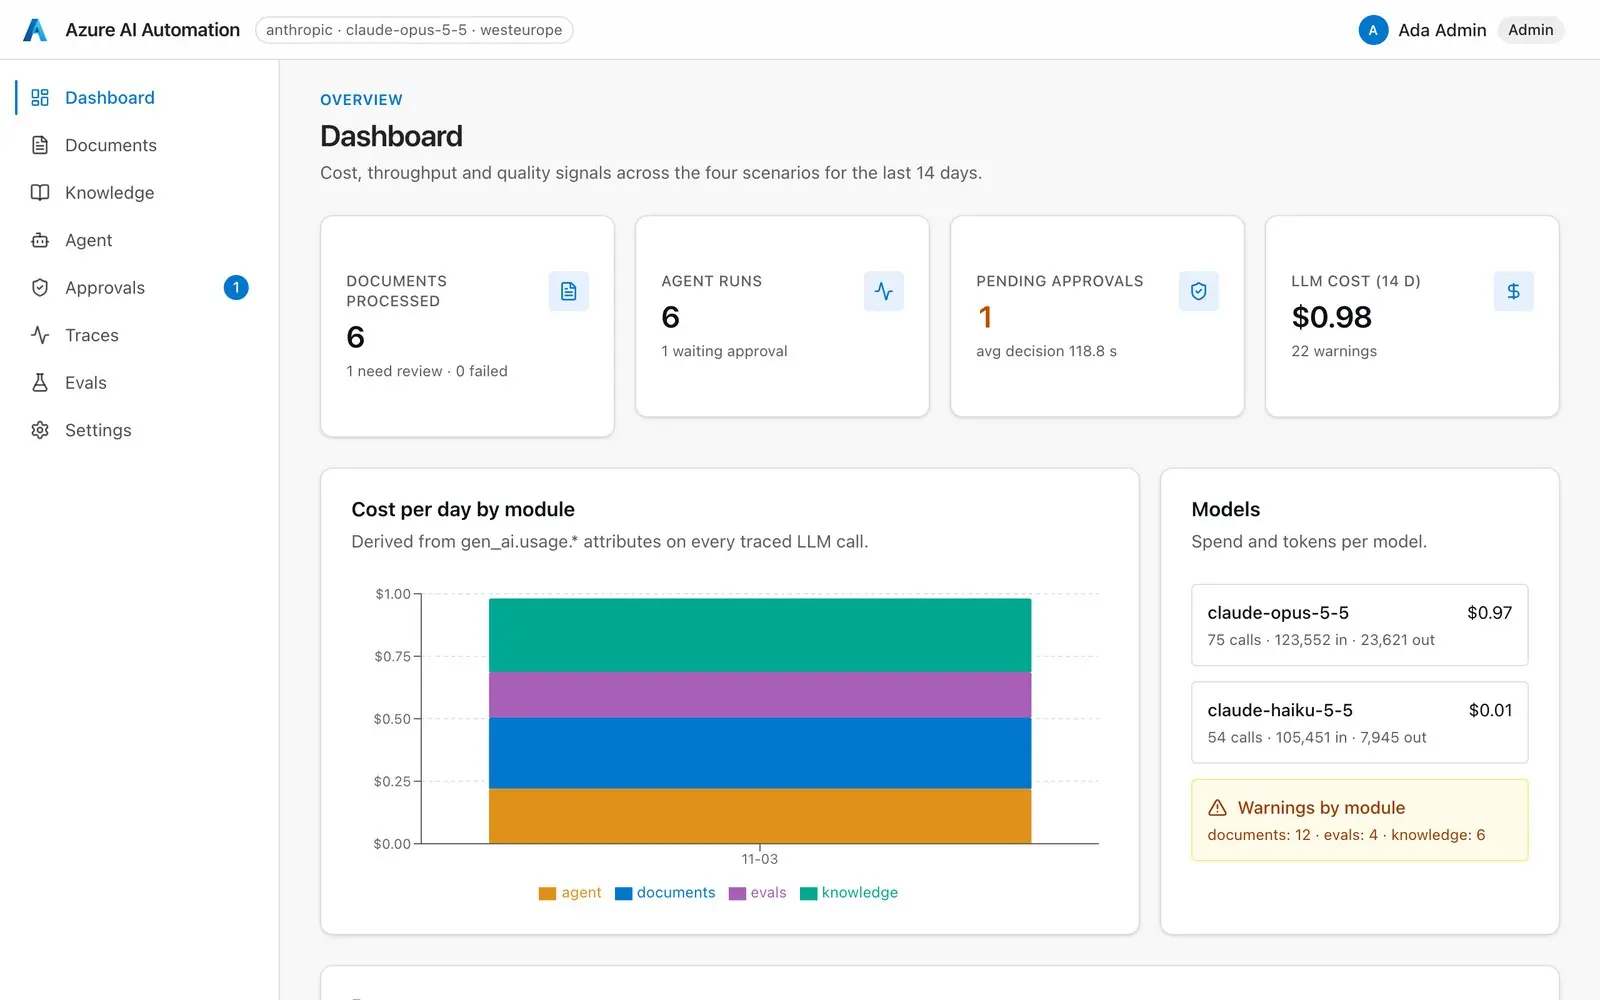
Coste y calidad en una sola vista. Documentos procesados, ejecuciones del agente, aprobaciones pendientes y gasto en modelos de los últimos 14 días, desglosados por módulo y por modelo.
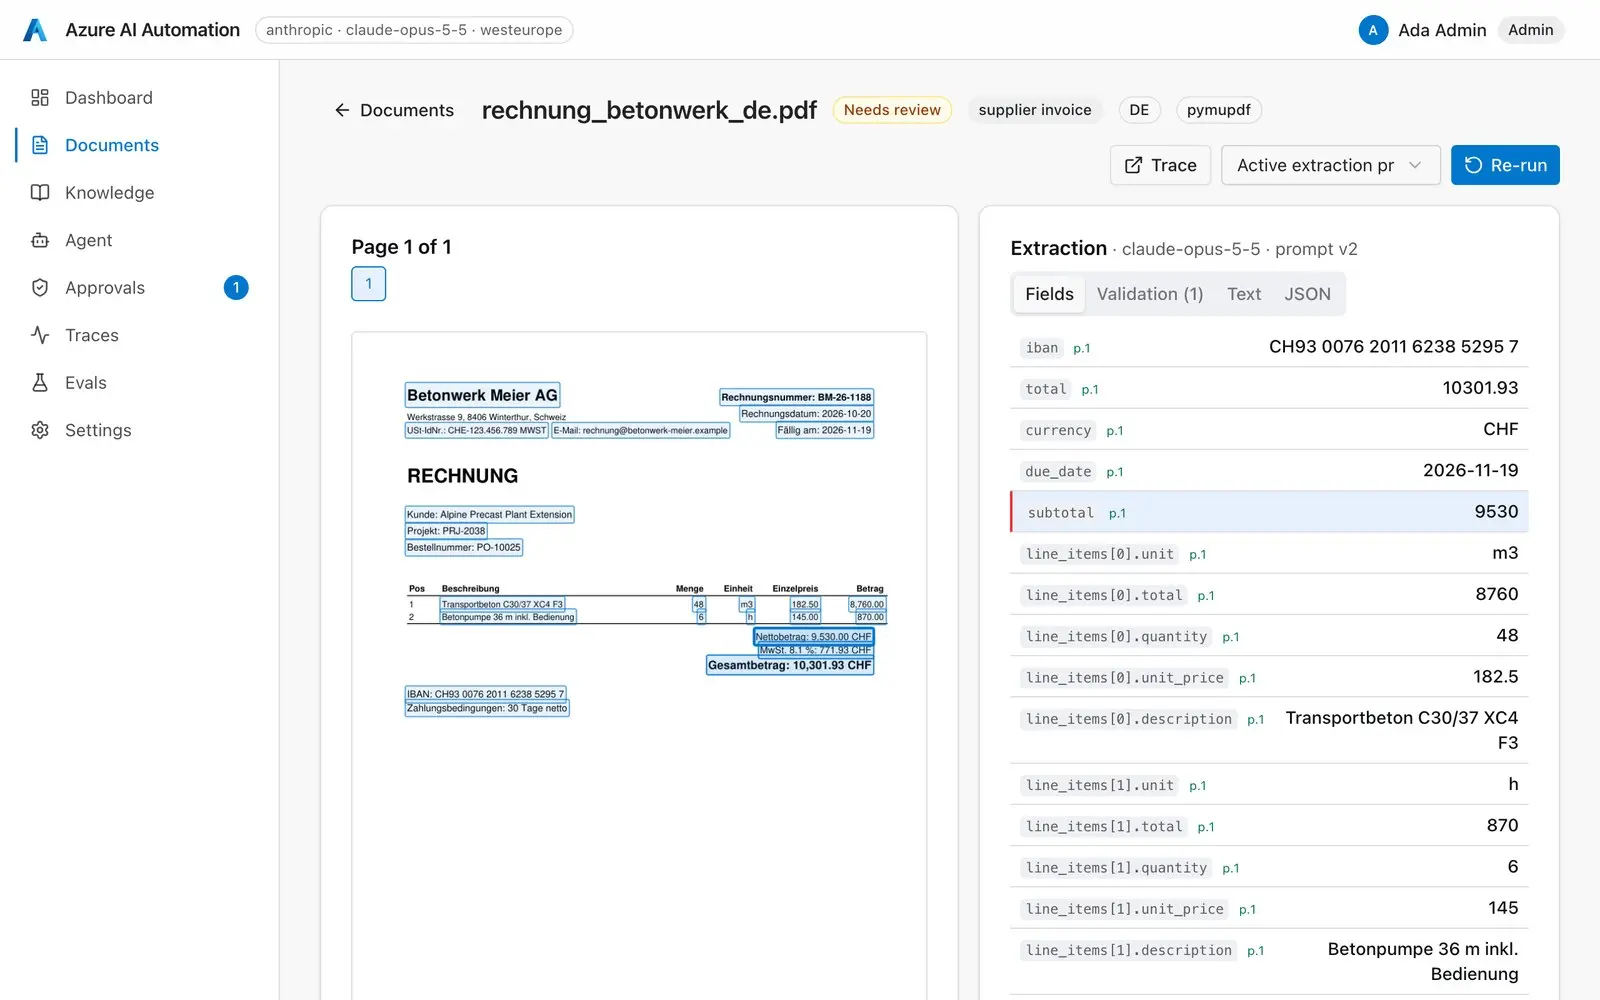
Extracción de documentos con procedencia. La canalización extrae palabras con coordenadas (PyMuPDF, Azure AI Document Intelligence u OCR por visión para escaneos), clasifica el documento y extrae un registro tipado con salidas estructuradas. Cada campo cita su texto de origen, así que el revisor hace clic en un valor y ve de qué parte de la página salió.
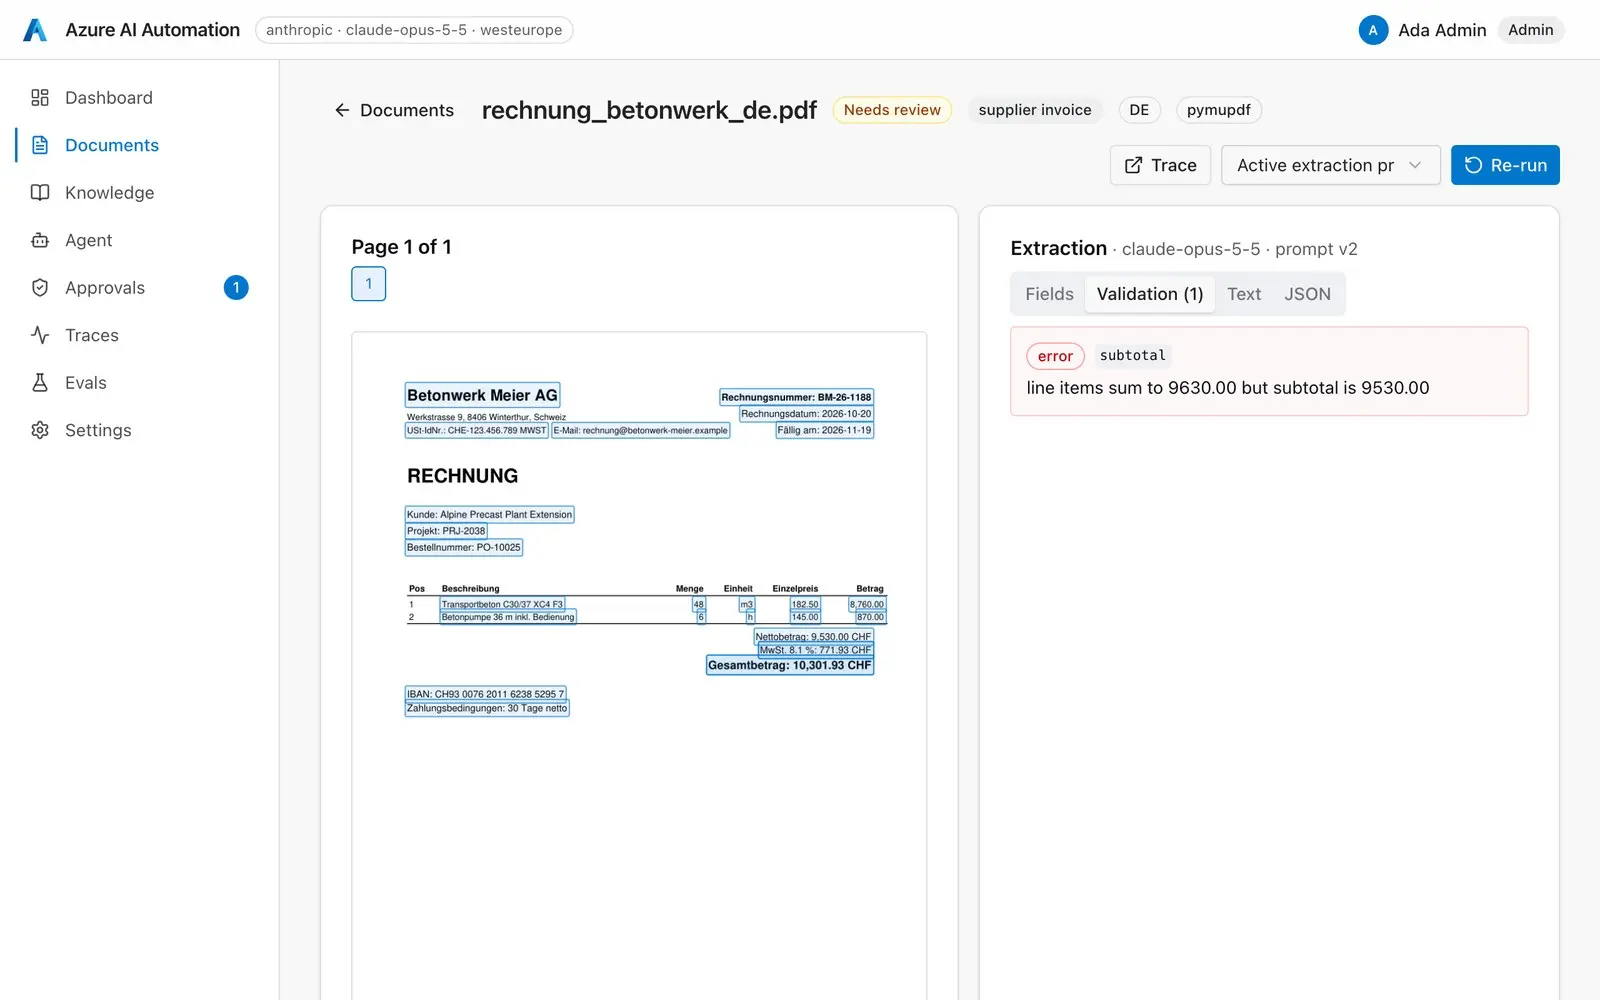
Reglas antes de contabilizar. Comprobaciones deterministas validan totales, fechas y lógica entre campos. Aquí las líneas no suman el subtotal, así que la factura va a revisión en lugar de a contabilidad.
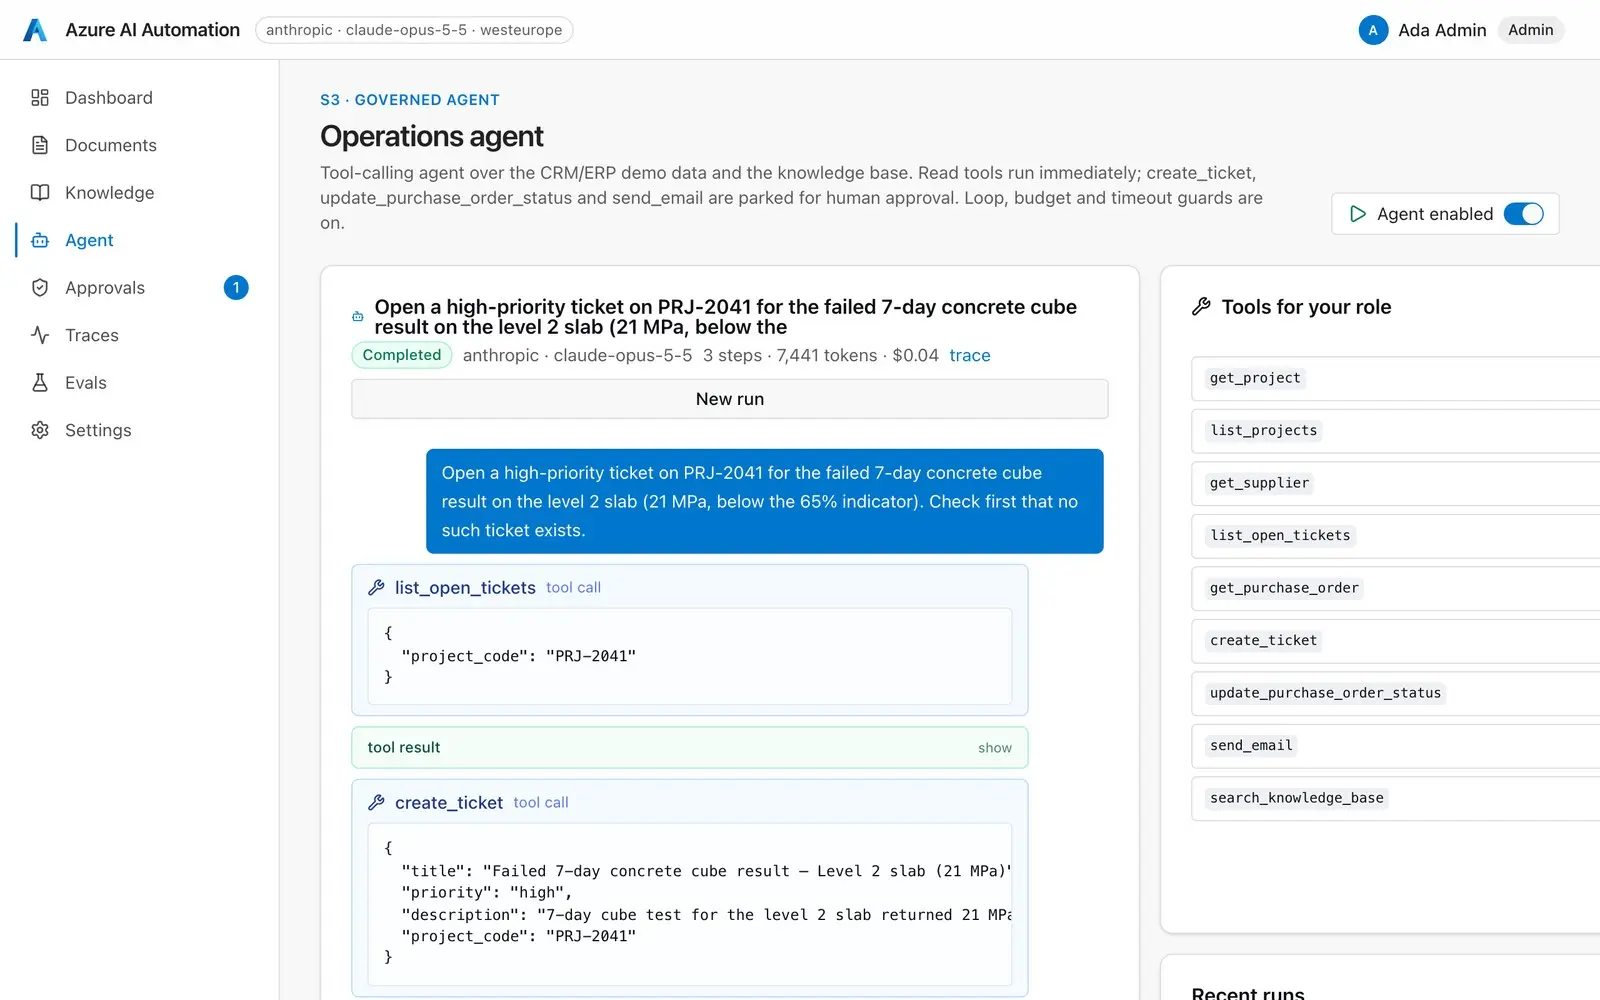
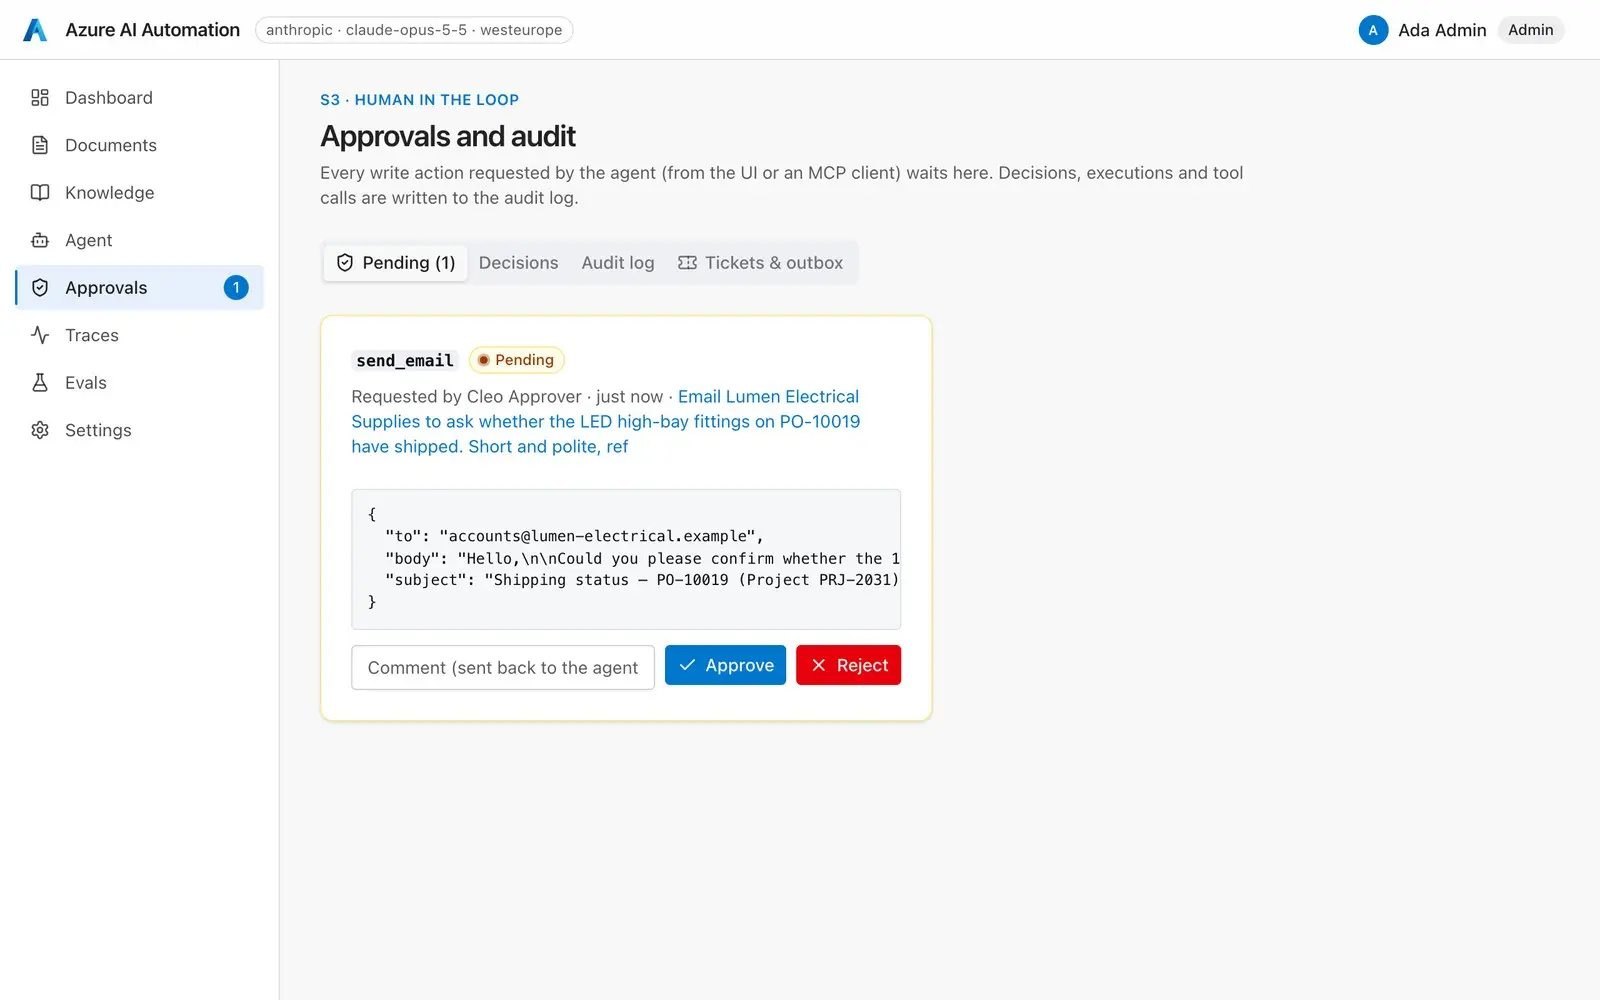
Un agente gobernado. Un agente con herramientas consulta proyectos, proveedores, pedidos y tickets, y busca en la base de conocimiento. Todo lo que escribe (un ticket, el estado de un pedido, un correo a un proveedor) queda aparcado para un aprobador; el worker lo ejecuta tras la aprobación y la ejecución continúa. Lo rodean permisos de herramientas por rol, detección de bucles, presupuestos de tokens, tiempos límite, un interruptor de parada y un registro de auditoría completo.
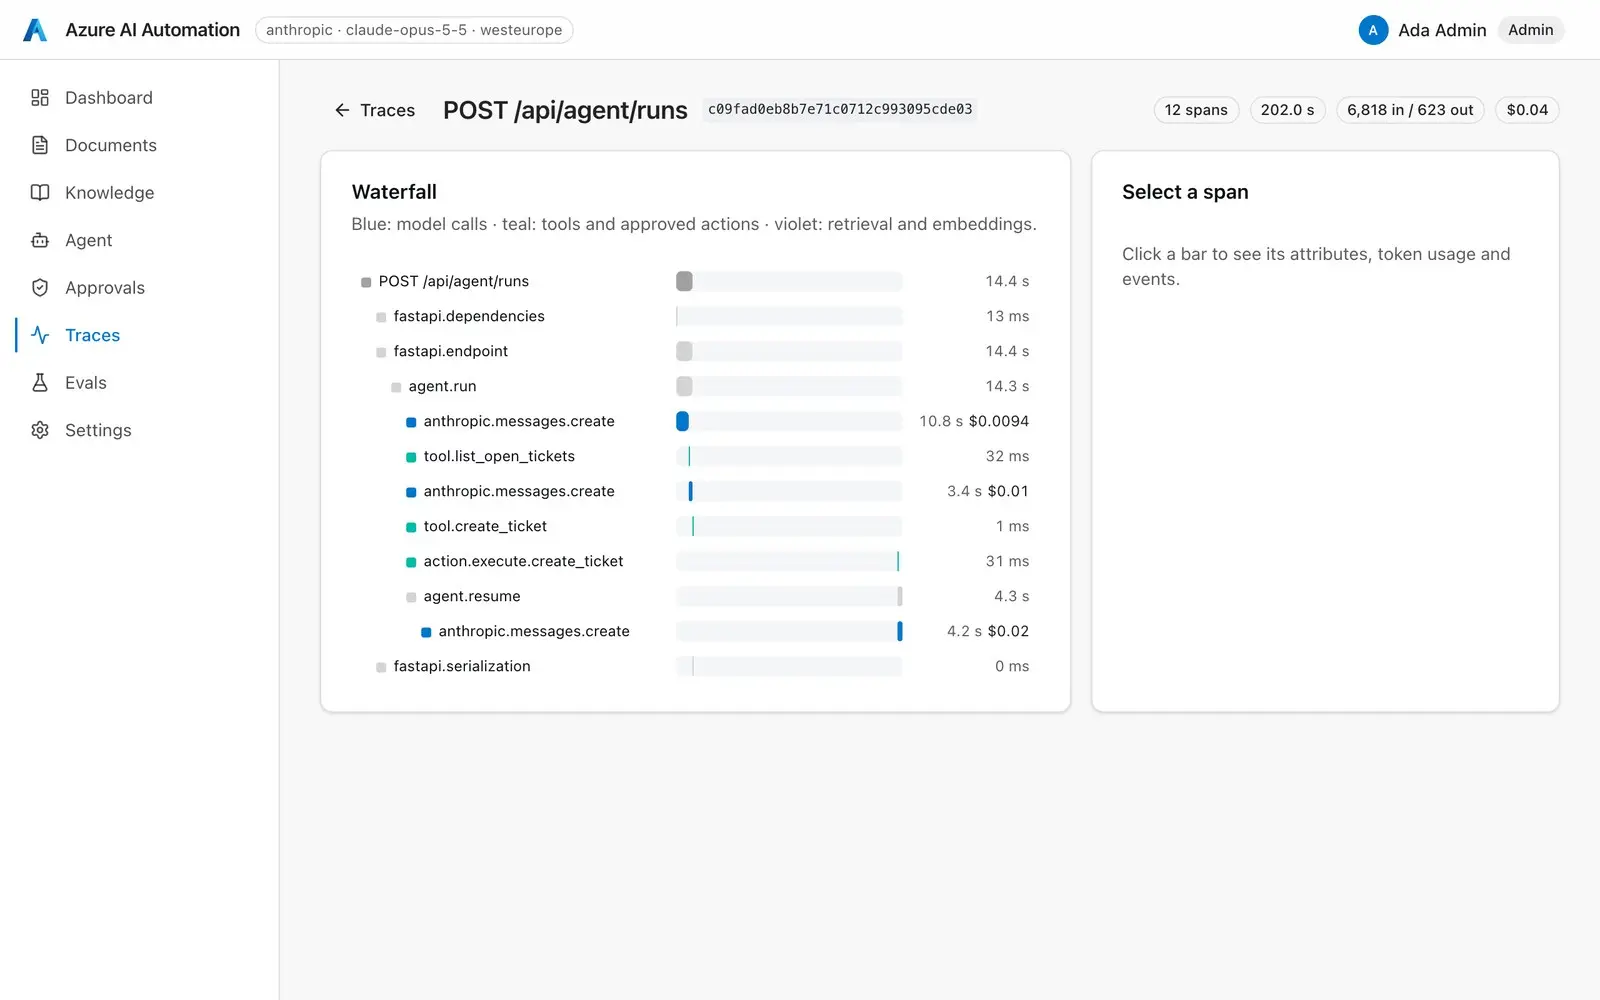
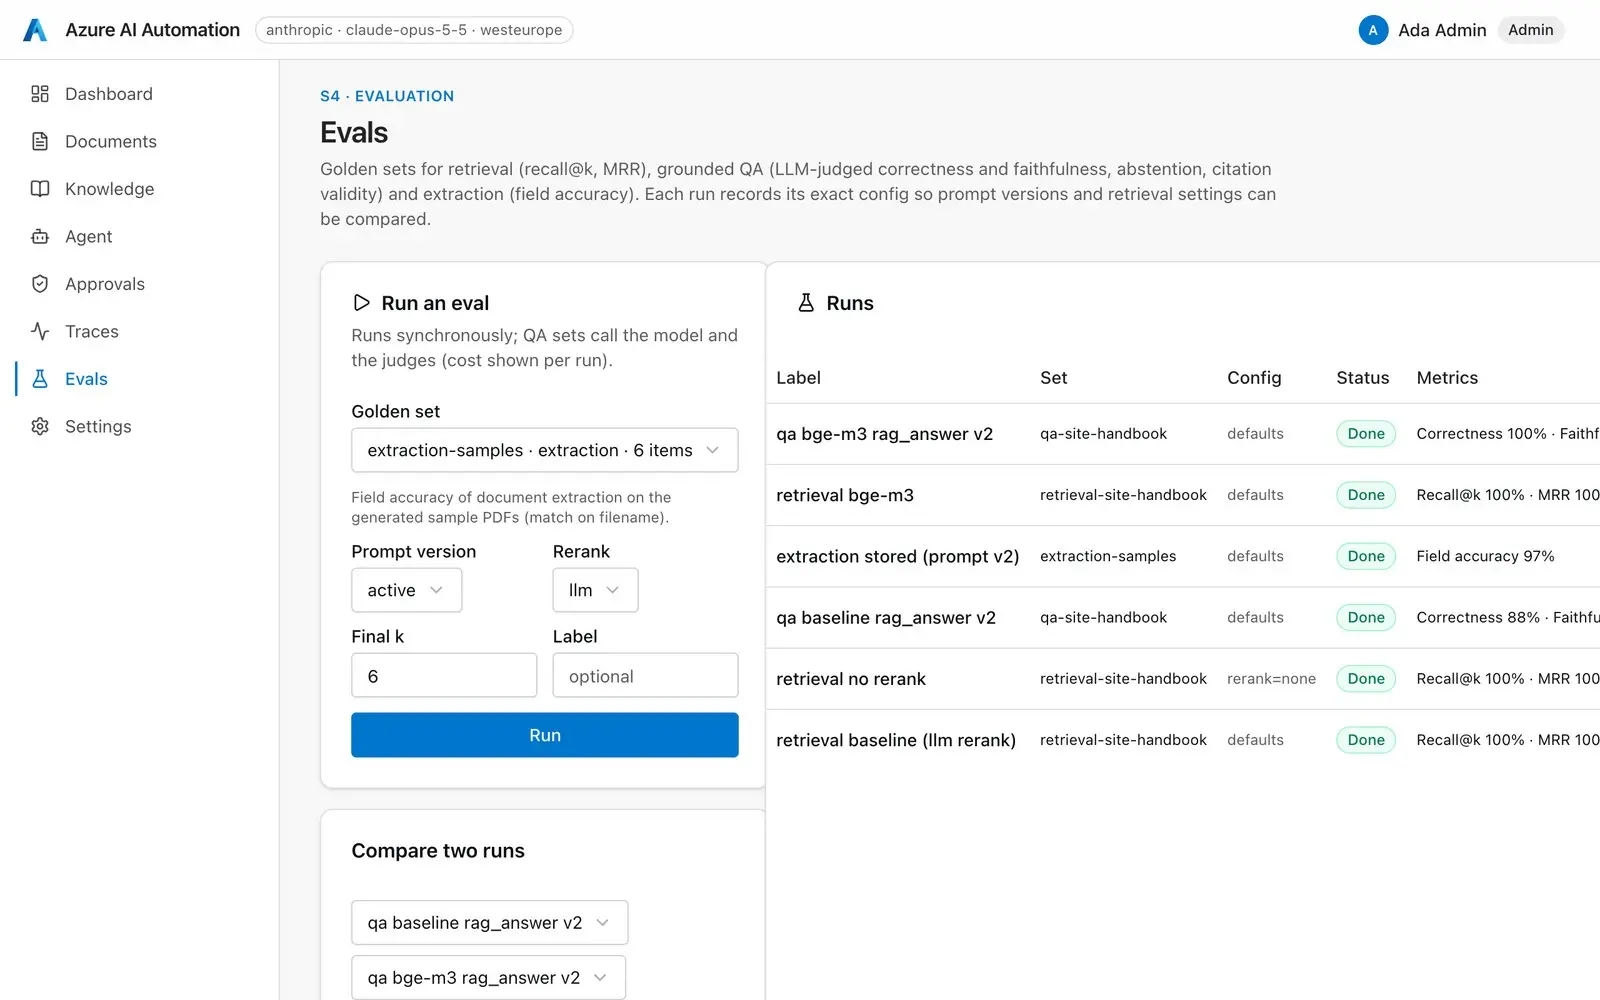
Trazado y medido. Cada ejecución es una traza OpenTelemetry con tokens y coste por llamada, visible en la aplicación o en Application Insights. Los prompts están versionados y los conjuntos de referencia miden recall de recuperación, corrección y fidelidad de las respuestas, abstención y precisión de extracción. Con los datos de demostración, cambiar a un modelo de embeddings multilingüe llevó la corrección de respuestas y la precisión de abstención de 0,875 a 1,00; fue la vista de evals la que mostró la diferencia.
Cómo se ejecuta
Primero en local: un solo docker compose up levanta la API, el worker, la interfaz, PostgreSQL con pgvector y Azurite, sin necesitar recursos de Azure. El mismo código se despliega en Azure Container Apps con identidad administrada, Key Vault, almacenamiento Blob y Queue, PostgreSQL Flexible Server, Document Intelligence y Log Analytics, todo definido en Bicep.
Proyectos relacionados
Chatbot RAG sobre regulación cripto (GPT-4 + Pinecone)
IA y agentes · Bases de datos e ingeniería de datos · Cloud, DevOps y LLMOps
Motor de lead scoring y detección de churn con IA (S1mple.ai)
ERP y SaaS con IA · IA y agentes · Marketing con IA y analítica · Bases de datos e ingeniería de datos
Virgil.ai: asistente agéntico de seguros de salud
IA y agentes · ERP y SaaS con IA · Cloud, DevOps y LLMOps · Seguridad y cumplimiento