
AI Engineering
¿Qué LLM usar? GPT, Claude, Gemini, Grok, Qwen y DeepSeek comparados
Por David Gadyan · Publicado el · 23 min de lectura
No existe el mejor LLM, solo el modelo adecuado para cada carga de trabajo. Este artículo compara las nueve familias de modelos que importan en noviembre de 2026, OpenAI, Anthropic, Google, xAI, Meta, Mistral, Alibaba Qwen, DeepSeek y Microsoft Decision-1, en doce tablas: buques insignia y escalones más baratos, precios, ventanas de contexto, pesos abiertos, los casos de uso que encajan con cada uno, API propietaria frente a pesos autoalojados, arquitecturas densas, de mezcla de expertos, de razonamiento y de decisión, y un enrutador que envía cada tarea al modelo más barato que la hace bien.
Un cliente me preguntó el mes pasado a qué modelo debía llamar su nuevo asistente: GPT, Claude, Gemini o "uno de los abiertos". La respuesta honesta es una tabla, no un nombre. Cada familia del mercado está optimizada para una carga de trabajo distinta, y la forma más barata de construir un buen sistema es entender qué modelo usar para cada trabajo, cómo combinarlos y cuándo autoalojar sale mejor que una API.
Este artículo es la comparación que me habría gustado tener en esa llamada. Cubre las nueve familias que importan en noviembre de 2026: OpenAI GPT, Anthropic Claude, Google Gemini, xAI Grok, Meta (Llama y ahora Muse), Mistral, Alibaba Qwen, DeepSeek y Microsoft Decision-1, un nuevo tipo de modelo que merece su propio artículo. Continúa la serie que empezó con Snowflake vs Databricks y Azure, Fabric, Databricks o Foundry, y termina con el código de enrutado que uso de verdad.
La respuesta corta
Elige por trabajo, no por marca. Para agentes generales y llamadas a herramientas, empieza por GPT o Claude. Para agentes de ingeniería de software, Claude primero. Para imágenes, vídeo y conjuntos de documentos muy grandes, Gemini. Para señales sociales y de mercado en tiempo real, Grok. Para todo lo que deba quedarse en tu propio hardware, Qwen, DeepSeek, Llama o Mistral sobre vLLM. Para clasificar, enrutar y calificar con volumen, Microsoft Decision-1. Después compara dos candidatos con tus propios datos, porque cada afirmación de abajo es una afirmación del proveedor hasta que tu conjunto de evaluación diga otra cosa.
Todo esto se comprobó el 6 de noviembre de 2026 contra las páginas de modelo de los proveedores y el informe de AI Board del 26 de octubre de 2026, que cita una fuente del proveedor por línea. Los precios son precios de lista públicos por millón de tokens, entrada y después salida, sin descuentos por volumen ni tarifas por lotes.
¿Por qué no hay un único mejor LLM?
Porque las familias están optimizadas para cosas distintas. Unas lideran en razonamiento complejo y matemáticas; otras en leer y editar bases de código grandes; otras en vídeo, audio y documentos de un millón de tokens; otras en ser baratas y rápidas para trabajo de producción con mucho volumen; y otras publican sus pesos para que los ejecutes en una GPU que controlas. Un modelo que encabeza una de esas listas rara vez es el primero en las demás, y la diferencia de precio entre la gama alta y la media es de cinco a diez veces.
Hay tres tipos de proveedor, y la distinción importa más que cualquier benchmark:
| Categoría | Proveedores | Qué obtienes |
|---|---|---|
| API propietaria y comercial | OpenAI, Google, Anthropic, xAI, Microsoft | Inferencia gestionada, los modelos más potentes, llamadas a herramientas, sin hardware que operar |
| Pesos abiertos | Alibaba Qwen, DeepSeek, Meta, Mistral, OpenAI gpt-oss, NVIDIA Nemotron | Pesos que descargas y sirves tú mismo; personalización y control de los datos |
| Plataformas empresariales | Microsoft Foundry, Amazon Bedrock, Gemini Enterprise Agent Platform | Un contrato y un sistema de identidad para los modelos de varios proveedores, más evaluación y gobernanza |
Pesos abiertos no significa código abierto. Qwen y DeepSeek publican pesos, pero la licencia, los datos de entrenamiento y las condiciones de uso comercial cambian en cada versión, y algunas familias publican solo sus modelos pequeños.
¿Qué modelos insignia están vigentes en noviembre de 2026?
Un buque insignia por laboratorio, tal como lo describen los laboratorios. La columna UE dice si el proveedor documenta una ruta para procesar dentro de la Unión Europea, algo que para muchos de mis clientes decide la cuestión antes que la calidad.
| Laboratorio | Buque insignia | Lanzamiento | Ventana de contexto | Pesos abiertos | Precio de lista (entrada / salida, por 1M) | Ruta UE |
|---|---|---|---|---|---|---|
| OpenAI | GPT-6 Astra | 3 sep 2026 | 1.050.000 | No | 10 $ / 50 $ | Sí, procesamiento UE de OpenAI con MAM o ZDR aprobados |
| Anthropic | Claude Fable 5.1 | 1 sep 2026 | 1.000.000 | No | 10 $ / 50 $ | Sí, multirregión eu de Google Cloud |
| Gemini 4 Argon | 13 oct 2026 | 1.048.576 | No | 2 $ / 10 $ (introductorio) | Sí, multirregión eu de Google Cloud | |
| xAI | Grok 4.7 | 21 sep 2026 | 500.000 | No | 2 $ / 6 $ | Sin endpoint UE documentado |
| Meta | Muse Wonder | 12 oct 2026 | 1.000.000 | No | 4 $ / 20 $ | Sin residencia UE documentada |
| DeepSeek | DeepSeek-V4-Pro | 13 ago 2026 | 1.000.000 | Sí, MIT | 1,32 $ / 3,96 $ (hora punta; mitad fuera de ella) | Autoalojado o GPU alquiladas en la UE |
| Mistral AI | Mistral Medium 3.5 | 28 abr 2026 | 256.000 | Sí, MIT modificada | 1,50 $ / 7,50 $ | Sí, Mistral Regional Endpoints en Europa |
| Alibaba | Qwen3.8-Max | 3 ago 2026 | 1.000.000 | Versión abierta bajo licencia propia | 2 $ / 6 $ | Alibaba Cloud Model Studio, Fráncfort |
| Microsoft | Microsoft Decision-1 (modelo de decisión, no un LLM) | 9 oct 2026 | 32.768 de entrada | No | 0,042 $ / gratis | A través de Microsoft Foundry; comprueba las regiones de despliegue |
Tres cosas que se leen en esa tabla. La ventana de un millón de tokens es ya la norma en la gama alta: seis de los ocho buques insignia de lenguaje publican un millón de tokens o más. La diferencia de precio entre los dos buques insignia más caros y DeepSeek es de unas ocho veces. Y el buque insignia más nuevo de OpenAI consiguió una ruta UE documentada solo a finales de octubre, con condiciones, mientras su generación anterior llevaba meses en nueve regiones europeas de Azure: la norma de residencia reduce tu elección de modelo, así que comprueba el modelo concreto, no el proveedor.
¿Qué escalones más baratos hay debajo de cada buque insignia?
La mayor parte del tráfico de producción no debería correr sobre un buque insignia. Estos son los escalones que evalúo primero, con sus precios publicados.
| Familia | Gama media | Pequeño y rápido | Notas |
|---|---|---|---|
| OpenAI | GPT-6.1 Terra, 1 $ / 5 $, 1.050.000 tokens (26 oct 2026); GPT-6 Sol | GPT-5.6 Luna, 0,20 $ / 1,20 $ | Terra cuesta la mitad que GPT-5.6 Terra; Luna es el escalón rápido para redactar y resumir |
| Anthropic | Claude Opus 5.5, 4 $ / 20 $ (22 sep); Claude Sonnet 5.5, 2 $ / 10 $ (28 sep) | Claude Haiku 5.5 (7 oct) | Anthropic señala Opus 5.5 como punto de partida para la mayoría de cargas y Sonnet 5.5 como sucesor de Sonnet 4.5 |
| Gemini 3.8 Flash, 0,75 $ / 3,75 $ introductorio hasta el 31 dic 2026, después 1,50 $ / 7,50 $ | Gemini 3.5 Flash-Lite, 0,30 $ / 2,50 $ | Presupuesta el precio posterior a enero | |
| xAI | Grok 4.6, 2 $ / 6 $ | Grok 4.3, 1,25 $ / 2,50 $ | Por encima de 200K tokens la tarifa de Grok se duplica |
| Meta | Muse Spark 1.3, 1,25 $ / 4,25 $ | Muse Glimmer 30B, pesos abiertos, Apache-2.0 | Muse Spark Open (15 oct 2026) añade pesos abiertos a la línea Spark; Llama 4 sigue descargable |
| DeepSeek | DeepSeek-V4-Flash, 0,44 $ / 1,32 $; V4.1-Flash (10 sep 2026) | El mismo modelo, a mitad de precio fuera de hora punta | Pesos MIT en los dos tamaños de V4 |
| Mistral AI | Mistral Large 3, 0,50 $ / 1,50 $, Apache-2.0; Mistral Large 4 en vista previa pública desde el 6 oct 2026 | Mistral Small 4, 0,15 $ / 0,60 $, Apache-2.0 | Large 3 es más barato que Medium 3.5 pese al nombre |
| Alibaba | Qwen3.8-Flash, 0,15 $ / 0,47 $ | Qwen3.8-27B, pesos abiertos, Apache-2.0, 262.144 tokens nativos | El 27B es el modelo abierto más práctico para una sola GPU de centro de datos |
¿Para qué sirve mejor cada familia de modelos?
Esto es posicionamiento a partir de mis propios proyectos y lecturas, no una clasificación medida. Toma cada fila como el primer candidato a evaluar, no como el ganador.
| Familia | Donde más destaca | Casos de uso típicos |
|---|---|---|
| OpenAI GPT | Razonamiento general, llamadas a herramientas, entrada multimodal, el ecosistema más amplio | Agentes de IA, RAG, asistentes de programación, análisis financiero, procesamiento de documentos, automatización de flujos |
| Anthropic Claude | Ingeniería de software sobre bases de código grandes, seguimiento de instrucciones largas, análisis de documentos | Agentes de programación, revisión de código, análisis de arquitectura, documentos legales, flujos de negocio complejos |
| Google Gemini | Comprensión de vídeo, audio e imagen, documentos de un millón de tokens, integración con Google Cloud y BigQuery | Análisis de vídeo, pipelines de OCR, inteligencia documental, RAG multimodal, análisis de datos a gran escala |
| xAI Grok | Información en tiempo real del ecosistema X, conversaciones y tendencias actuales | Sentimiento social, monitorización de criptomonedas y mercados, análisis de noticias de última hora, detección de tendencias |
| Alibaba Qwen | La línea de pesos abiertos más amplia: tamaños de 0,6B a 2,4T, variantes coder, visión, omni, embedding y reranker | RAG privado, chatbots a medida, inferencia local, extracción de documentos, modelos de dominio ajustados |
| DeepSeek | Razonamiento y programación eficientes en coste; mezcla de expertos a escala de frontera con pesos MIT | Generación de código, razonamiento matemático, análisis de datos, agentes autónomos, inferencia privada |
| Meta Llama y Muse | Autoalojamiento y ajuste fino (Llama 4, Muse Glimmer 30B, Muse Spark Open); Muse Wonder a través de la Meta Model API | Despliegues privados, chatbots internos, modelos empresariales ajustados |
| Mistral AI | Modelos europeos eficientes con endpoints en la UE; Codestral y Devstral para código, Pixtral para visión, Mistral OCR para documentos | IA empresarial europea, agentes de programación, extracción de documentos, despliegues con la soberanía por delante |
| Microsoft Decision-1 | Decisiones rápidas y calibradas sobre opciones fijas; no es un chatbot | Enrutado de agentes, clasificación, priorización, calificación de respuestas de IA, control de flujos |
Otras familias que conviene conocer: Moonshot Kimi K3 (razonamiento y agentes, ventana de 1.048.576 tokens), Zhipu GLM-5.3 (razonamiento y código, pesos MIT en GLM-5.2), Cohere Command A+ (pesos Apache-2.0, embeddings y rerankers sólidos para RAG empresarial), NVIDIA Nemotron 3 Ultra (pesos abiertos para inferencia empresarial) y Amazon Nova (la línea nativa de AWS, los únicos modelos en la AWS European Sovereign Cloud en la comprobación de septiembre de 2026).
¿API propietaria o pesos abiertos autoalojados?
Esta es la mayor decisión de arquitectura, mayor que la elección del modelo. La Figura 1 muestra las dos rutas y la pila multimodelo que las combina; toca una capa para leer qué hace.
Tu código llama a OpenAI, Anthropic, Google o xAI directamente, o a los mismos modelos a través de Microsoft Foundry, Amazon Bedrock o Gemini Enterprise Agent Platform. El proveedor opera las GPU.
El producto que ve el usuario y la API que lo sirve.
Los bucles de agente, las llamadas a herramientas y el estado viven en tu código, responda el modelo que responda.
Los buques insignia actuales de OpenAI, Anthropic, Google y xAI a 6 de noviembre de 2026, cada uno detrás de su propia API; debajo de cada uno hay escalones más baratos.
Un contrato, una factura y un sistema de identidad para los modelos de varios proveedores, más evaluación y gobernanza.
Los documentos que el modelo puede leer, troceados, vectorizados e indexados en tu lado.
Sin GPU propias: tú operas los contenedores de la aplicación, el proveedor ejecuta la inferencia.
Las mismas preguntas y documentos se ejecutan contra cada modelo candidato antes y después de cada lanzamiento del proveedor.
La retención cero o el procesamiento regional es una cláusula del contrato, no un valor por defecto: pídelo por escrito.
Uso típico: La mayoría de los productos: lo más rápido de lanzar, los modelos más potentes, sin hardware que operar; pagas por token y tus datos salen de tu red bajo contrato.
Toca una capa para leer qué hace esa tecnología en esta pila.
| Capa | Tecnología | Qué hace |
|---|---|---|
| Tu aplicación | Next.js, FastAPI | El producto que ve el usuario y la API que lo sirve. |
| Orquestación | LangGraph, MCP tools | Los bucles de agente, las llamadas a herramientas y el estado viven en tu código, responda el modelo que responda. |
| Modelos | GPT-6 Astra, Claude Fable 5.1, Gemini 4 Argon, Grok 4.7 | Los buques insignia actuales de OpenAI, Anthropic, Google y xAI a 6 de noviembre de 2026, cada uno detrás de su propia API; debajo de cada uno hay escalones más baratos. |
| Plataforma empresarial (opcional) | Microsoft Foundry, Amazon Bedrock, Gemini Enterprise Agent Platform | Un contrato, una factura y un sistema de identidad para los modelos de varios proveedores, más evaluación y gobernanza. |
| Recuperación | PostgreSQL + pgvector, Azure AI Search | Los documentos que el modelo puede leer, troceados, vectorizados e indexados en tu lado. |
| Infraestructura | Provider GPUs, Your containers | Sin GPU propias: tú operas los contenedores de la aplicación, el proveedor ejecuta la inferencia. |
| Evaluación | MLflow, Golden test set | Las mismas preguntas y documentos se ejecutan contra cada modelo candidato antes y después de cada lanzamiento del proveedor. |
| Seguridad y datos | API keys in a vault, Data processing agreement | La retención cero o el procesamiento regional es una cláusula del contrato, no un valor por defecto: pídelo por escrito. |
| Capa | Tecnología | Qué hace |
|---|---|---|
| Tu aplicación | Next.js, FastAPI | Sin cambios: la aplicación habla con un endpoint compatible con OpenAI que resulta ser tuyo. |
| Orquestación | LangGraph, MCP tools | El mismo código de agente que en la ruta por API; solo cambia la URL base. |
| Servidor de inferencia | vLLM, SGLang, Ollama | Batching, caché KV, cuantización y una API compatible con OpenAI; Ollama para un portátil o una sola máquina, vLLM o SGLang para rendimiento en producción. |
| Modelos de pesos abiertos | Qwen3.8-27B, DeepSeek-V4-Flash, Llama 4, Mistral Medium 3.5, gpt-oss | Pesos que puedes descargar: Apache-2.0 (Qwen3.8-27B), MIT (DeepSeek V4), la licencia comunitaria de Llama 4, el MIT modificado de Mistral. Lee la licencia antes que la ficha del modelo. |
| GPU | NVIDIA GPUs, AWS / Azure / GCP GPU instances, On-premises | Instancias GPU alquiladas en la región que elijas, o tus propios servidores; planificar la capacidad pasa a ser tu trabajo. |
| Recuperación | PostgreSQL + pgvector, Open embedding model (bge-m3) | Los embeddings también se calculan en local, así que ningún documento sale de la red. |
| Evaluación | MLflow, Golden test set | Los ajustes finos (LoRA, QLoRA) solo merecen la pena si este conjunto de pruebas lo dice. |
| Operaciones | Kubernetes, Monitoring, Patching and upgrades | Escalado, monitorización, parches de seguridad y actualizaciones de modelo: el coste oculto de la ruta sin factura por token. |
| Capa | Tecnología | Qué hace |
|---|---|---|
| Petición | Customer, employee or API | Toda petición entra por la misma puerta, necesite lo que necesite. |
| Decisión y enrutado | Microsoft Decision-1 | Intención, prioridad y ruta, como probabilidades calibradas sobre opciones fijas, en una sola llamada barata; una probabilidad máxima baja envía el caso a una persona. |
| Razonamiento y código | Claude Opus 5.5, GPT-6 Sol | Análisis en varios pasos, planificación y generación de código, donde los tokens caros se ganan el sueldo. |
| Imágenes, vídeo y documentos | Gemini 4 Argon, Azure AI Document Intelligence | Facturas escaneadas, capturas y vídeo van a un modelo multimodal o a un servicio de documentos, no al enrutador de texto. |
| Inferencia privada | Qwen3.8-27B on vLLM, DeepSeek-V4-Flash | Los campos sensibles y la extracción masiva se quedan en tus GPU. |
| Señales en tiempo real | Grok 4.7 | Conversación social y de mercado cuando el caso de uso necesita lo que está pasando ahora. |
| Recuperación y herramientas | Vector store, SQL, CRM / ERP APIs | Los hechos salen de tus sistemas; los modelos solo los leen y actúan sobre ellos. |
| Verificación | Microsoft Decision-1, LLM judge | Aprobar, rechazar o escalar cada respuesta o acción generada contra una rúbrica antes de ejecutar nada. |
| Ejecución | Workflow (n8n, queue), Human approval | Actualizar el CRM, enviar la notificación, crear el informe; las escrituras importantes esperan a una persona. |
| Pregunta | API propietaria | Pesos abiertos autoalojados |
|---|---|---|
| Hardware | Ninguno tuyo; el proveedor opera las GPU | GPU NVIDIA que alquilas o posees, dimensionadas por ti |
| Modelo de coste | Por token; los buques insignia de 2 a 10 $ por millón de entrada | Horas de GPU más operaciones; sin factura por token de un proveedor |
| Calidad del modelo | Los modelos más potentes | Una generación por detrás en la cima, igual en la gama media (Qwen3.8-27B, DeepSeek-V4-Flash, Mistral Medium 3.5) |
| Camino de los datos | Sale de tu red bajo un acuerdo de tratamiento; retención cero y procesamiento regional son cláusulas del contrato | Nunca sale de tu VPC; los embeddings también se calculan en local |
| Personalización | Prompts, salidas estructuradas, ajuste fino limitado | Ajuste fino completo (LoRA, QLoRA), servidor propio, cuantización |
| Operaciones | Los límites de tasa y la disponibilidad son suyos | Escalado, batching, monitorización, parches y actualizaciones son tuyos |
| Coste de cambiar | Bajo detrás de una capa de abstracción | Bajo también: vLLM y SGLang exponen endpoints compatibles con OpenAI |
¿Qué puedes ejecutar en una GPU de 16 GB?
Una regla aproximada para un portátil con 16 GB de memoria de GPU, antes del dimensionamiento de producción. La memoria depende de la cuantización, la longitud de contexto, la caché KV y la arquitectura, así que tómalo como órdenes de magnitud.
| Tamaño del modelo | En una GPU de 16 GB |
|---|---|
| 1B a 3B | Muy holgado, precisión completa |
| 7B a 8B | Práctico a 16 bits, holgado a 8 bits |
| 14B | Práctico con cuantización a 4 bits y un contexto modesto |
| 32B | Compromisos importantes de cuantización o descarga a CPU |
| 70B y más | No es práctico en memoria de GPU; usa un servidor o una API |
En producción no usarías un portátil de todos modos: vLLM o SGLang en instancias GPU dedicadas, con el batching y la caché KV ajustados a tus longitudes de contexto.
¿Denso, mezcla de expertos, razonamiento o modelo de decisión?
No todos los modelos funcionan igual, y la arquitectura decide la memoria, la latencia y para qué sirve el modelo. La Figura 2 pone los cuatro tipos uno junto a otro.
| Arquitectura | Qué pasa por token | Memoria y latencia | Mejor aplicación |
|---|---|---|---|
| Densa | Participan todos los parámetros; un modelo de 27B calcula 27B pesos por token | La memoria equivale al número de parámetros; la latencia crece con el tamaño | Inferencia general, servicio sencillo, ajuste fino (Qwen3.8-27B, Mistral Medium 3.5) |
| Mezcla de expertos (MoE) | Un enrutador activa unos pocos expertos; DeepSeek-V4-Pro tiene 1,6T parámetros en total y 49B activos por token | Todos los expertos deben estar cargados, así que la memoria sigue siendo grande mientras el cómputo por token es pequeño | Modelos eficientes a escala de frontera (DeepSeek V4, Qwen3.8-Max, Mistral Large 3) |
| Razonamiento | El modelo gasta cómputo adicional trabajando el problema antes de la respuesta | Más latencia y coste por respuesta; el esfuerzo es regulable en los buques insignia de 2026 | Matemáticas, programación compleja, planificación, análisis en varios pasos, flujos de agentes |
| Decisión | El modelo puntúa un conjunto fijo de opciones en una pasada y devuelve una probabilidad por opción | Milisegundos, sin tokens de salida | Clasificación, enrutado, priorización, calificación (Microsoft Decision-1) |
Las categorías se solapan: DeepSeek-V4-Pro es una mezcla de expertos y un modelo de razonamiento, y Decision-1 está postentrenado a partir de un modelo Qwen denso de 9B.
¿Qué modelo deberías evaluar primero en cada proyecto?
Candidatos de partida, no ganadores garantizados. La columna derecha es la razón por la que el candidato está en la lista.
| Proyecto | Primeros modelos a evaluar | Por qué |
|---|---|---|
| Agentes de IA avanzados | GPT-6 Sol, Claude Opus 5.5 | Razonamiento, llamadas a herramientas, ejecución en varios pasos |
| Agentes de desarrollo de software | Claude Sonnet 5.5 u Opus 5.5, GPT-6.1 Terra, Qwen3-Coder | Comprensión, edición y refactorización de bases de código |
| Aplicaciones RAG | Claude Sonnet 5.5, GPT-6.1 Terra, Gemini 3.8 Flash, Qwen3.8-Flash | Respuestas fundamentadas sobre pasajes recuperados a precios de gama media |
| Comprensión de vídeo | Gemini 4 Argon | Procesamiento multimodal nativo de vídeo |
| Análisis financiero | GPT-6, Claude Opus 5.5, DeepSeek-V4-Pro | Razonamiento y análisis numérico |
| Inteligencia de criptomonedas y mercados | Grok 4.7, GPT-6, DeepSeek | Información actual más razonamiento analítico |
| Procesamiento de documentos | Gemini, GPT-6, Claude, más Azure AI Document Intelligence o Mistral OCR | Extracción multimodal con un servicio de documentos delante |
| IA empresarial privada | Qwen3.8-27B, DeepSeek-V4-Flash, Llama 4, Mistral Medium 3.5 | Autoalojamiento y personalización |
| Atención al cliente | GPT-6.1 Terra, Gemini 3.8 Flash, Qwen | Clasificación, generación de respuestas, automatización |
| Clasificación de alto volumen | Microsoft Decision-1, un Qwen pequeño | Decisiones estructuradas de bajo coste |
| Chatbot multilingüe | GPT, Gemini, Qwen | Comprensión y generación multilingües |
| Agentes de uso de ordenador | GPT-6.1 Terra, Claude | Interacción con interfaces de software |
¿Cómo se enruta entre modelos en producción?
No fijes un modelo en cada funcionalidad. Una capa de enrutado selecciona el modelo por tarea, y el tipo de tarea es solo la primera señal. El mío, en su forma más simple, es así:
class ModelRouter:
    """Elige el modelo por tarea; las cadenas son nombres de despliegue en Foundry o vLLM."""

    def select_model(self, task: str) -> str:
        if task == "classification":
            return "microsoft-decision-1"
        if task == "complex_reasoning":
            return "gpt-6-sol"
        if task == "coding":
            return "claude-sonnet-5-5"
        if task == "multimodal":
            return "gemini-4-argon"
        if task == "private_inference":
            return "qwen3.8-27b"
        if task == "social_intelligence":
            return "grok-4.7"
        if task == "cost_efficient_reasoning":
            return "deepseek-v4-flash"
        return "gpt-6.1-terra"
En producción el enrutador pondera más que el tipo de tarea:
- Calidad esperada en esa tarea, según tu propio conjunto de evaluación, no una clasificación pública.
- Precio por millón de tokens, entrada y salida, incluidas las tarifas de entrada en caché cuando el proveedor publica una.
- Número de tokens de la petición: un prompt de 300K tokens descarta la tarifa estándar de Grok y el límite de entrada de 32K de Decision-1.
- Requisitos de latencia: un modelo de decisión responde en milisegundos, un buque insignia de razonamiento en segundos.
- Ventana de contexto, y si la ventana útil es tan larga como la anunciada.
- Sensibilidad de los datos: los campos privados van a la ruta autoalojada; el resto puede usar una API bajo las condiciones acordadas.
- Disponibilidad de cada proveedor, con un modelo de reserva y una política de reintentos.
- Fechas de retirada de cada nombre de modelo, para que un apagado sea un cambio de una línea.
Ejemplo: un pipeline multimodelo de facturas
Una aplicación de contabilidad que recibe 10.000 facturas al mes no necesita un buque insignia en cada paso. La ventaja del diseño multimodelo es que los tokens caros van solo donde se ganan el sueldo, y la aritmética va a Python.
| Etapa | Modelo o herramienta | Responsabilidad |
|---|---|---|
| Ingesta de documentos | Azure AI Document Intelligence o Google Document AI | OCR y extracción estructurada |
| Comprensión de documentos | Gemini 4 Argon o GPT-6.1 Terra | Diseños de factura inusuales que el servicio de extracción no captó |
| Validación de datos | Python y SQL | Importes, IVA y números de factura, de forma determinista |
| Clasificación y priorización | Microsoft Decision-1 | Qué excepciones necesitan una persona, y en qué orden |
| Razonamiento financiero complejo | Claude Opus 5.5 o GPT-6 Sol | Investigar transacciones inusuales |
| Procesamiento privado | Qwen3.8-27B o DeepSeek-V4-Flash sobre vLLM | Campos sensibles que no deben salir de la red |
| Aprobación final | Una persona, o un flujo controlado | Cualquier decisión financiera importante |
¿Qué cambió en septiembre y octubre de 2026?
Cada semana llegan modelos nuevos, y de vez en cuando se apaga uno viejo. Estos son los lanzamientos de los ocho laboratorios de modelos de lenguaje más Microsoft entre el 10 de septiembre y el 26 de octubre de 2026, tal como los lista el informe de AI Board del 26 de octubre con una fuente del proveedor por línea.
| Fecha | Laboratorio | Modelo | Qué es |
|---|---|---|---|
| 26 oct 2026 | OpenAI | GPT-6.1 Terra | Modelo rápido y eficiente para razonamiento visual, uso de ordenador y redacción; 1 $ / 5 $ |
| 15 oct 2026 | Meta | Muse Spark Open | Pesos abiertos, descargables desde Hugging Face, Google Cloud y Microsoft Foundry |
| 13 oct 2026 | Gemini 4 Argon | Modelo de razonamiento insignia, disponible de forma general | |
| 12 oct 2026 | Meta | Muse Wonder | El modelo Muse más capaz de Meta en la Meta Model API |
| 9 oct 2026 | Microsoft | Microsoft-Decision-1 | Modelo de puntuación de decisiones, disponible de forma general en Foundry |
| 7 oct 2026 | Anthropic | Claude Haiku 5.5 | El escalón Claude más rápido |
| 6 oct 2026 | Mistral | Mistral Large 4 | Vista previa pública; pesos abiertos anunciados para después |
| 29 sep 2026 | OpenAI | GPT-6.1 Sol | Programación compleja y trabajo profesional a menor coste que GPT-6 Astra |
| 28 sep 2026 | Anthropic | Claude Sonnet 5.5 | Sucesor de Sonnet 4.5; 2 $ / 10 $ |
| 22 sep 2026 | Anthropic | Claude Opus 5.5 | Programación y trabajo de conocimiento de larga duración; 4 $ / 20 $ |
| 21 sep 2026 | xAI | Grok 4.7 | Buque insignia para código, agentes y trabajo de conocimiento; 500.000 tokens |
| 10 sep 2026 | DeepSeek | DeepSeek-V4.1-Flash | El modelo más pequeño de la nueva generación, lee imágenes; actualizado el 17 oct |
¿Qué modelos se retiran, y cuándo?
Un modelo queda obsoleto cuando el proveedor anuncia una fecha de fin y sigue respondiendo; se retira el día en que todas las llamadas fallan. El periodo de aviso es la única ventana en la que una migración es barata: OpenAI promete al menos seis meses para modelos disponibles de forma general, Anthropic al menos 60 días, Google Cloud al menos 45 días para modelos de vida corta.
| Fecha | Laboratorio | Modelos | Sustituto que nombra el proveedor |
|---|---|---|---|
| 23 oct 2026 (hecho) | OpenAI | GPT-4, GPT-4 Turbo, GPT-3.5 Turbo, o1, o1-pro, o3-mini, o4-mini, GPT-4.1 nano | GPT-5.6 Sol, Terra o Luna, según el modelo |
| 30 nov 2026 | Anthropic | Claude Sonnet 4.5 en las plataformas propias de Anthropic | Claude Sonnet 5.5 |
| 11 dic 2026 | OpenAI | gpt-5, gpt-5-mini, gpt-5-nano, gpt-5-pro, o3, o3-pro | GPT-5.6 Sol, Terra o Luna, según el modelo |
| 14 ene 2027 | OpenAI | GPT-4o, GPT-4o mini, GPT-4.1, GPT-4.1 mini | GPT-6 Luna |
| 1 abr 2027 | OpenAI | gpt-5.1, gpt-5.3-codex, gpt-5.4-nano | GPT-6 Sol y GPT-6 Luna |
Los modelos de producción con nombre han durado entre doce y veintidós meses antes del apagado. Planifica entre seis y dieciocho meses de vida útil por versión de modelo, y conserva el conjunto de evaluación que eligió el modelo para poder repetirlo sobre el sucesor.
¿Qué modelo deberías elegir?
La Figura 3 es el flujo de decisión que recorro con los clientes. Cuatro preguntas cubren la mayoría de los casos; la nota al pie cubre el resto.
Cuándo no cambiar:
- Un modelo nuevo rara vez es motivo para cambiar. El sucesor da respuestas distintas sobre tus documentos aunque sea mejor; repite el conjunto de evaluación antes de moverte.
- No escribas "siempre el modelo más reciente" en una política. El buque insignia de septiembre de 2026 cuesta ocho veces más por millón de tokens de entrada que el de un año antes.
- No pagues razonamiento en resúmenes fundamentados. El razonamiento ayuda en problemas abiertos y puede perjudicar en tareas donde la respuesta está en el pasaje recuperado; solo tu propia prueba te dice en qué caso estás.
- No mandes una decisión de opciones fijas a un buque insignia. Un modelo de decisión o un modelo abierto pequeño lo hace en milisegundos por céntimos.
¿Qué debería aprender un arquitecto de IA?
La habilidad es combinar modelos, no llamar a una API. Este es el orden en el que yo estudiaría.
| Habilidad | Qué entender |
|---|---|
| APIs de LLM | Las APIs de OpenAI, Anthropic, Gemini, xAI y DeepSeek, y la Decisions API de Microsoft Foundry |
| Servicio de modelos | vLLM, SGLang, Ollama; batching, caché KV, cuantización |
| Enrutado de modelos | Elegir por tarea según calidad, coste, latencia, contexto, sensibilidad y disponibilidad |
| Ajuste fino | LoRA, QLoRA, ajuste fino supervisado, y cuándo no merece la pena |
| RAG | Embeddings, búsqueda híbrida, reranking, bases de datos vectoriales, conjuntos de pruebas |
| Agentes de IA | LangGraph, llamadas a herramientas, MCP, puertas de aprobación humana |
| Evaluación | Precisión, alucinaciones, latencia y coste por tarea, seguidos por versión de modelo |
| Infraestructura GPU | CUDA, batching, cuantización, planificación de memoria |
| Seguridad empresarial | Aislamiento de datos, control de acceso, gobernanza, residencia |
| Plataformas de IA en la nube | Microsoft Foundry, Amazon Bedrock, Gemini Enterprise Agent Platform |
El proyecto práctico que lo enseña todo: una plataforma empresarial multimodelo con Microsoft Foundry como capa de gestión de modelos, GPT, Claude y Gemini como proveedores externos, Qwen y DeepSeek sobre vLLM, Microsoft Decision-1 para enrutar y clasificar, LangGraph para la orquestación, PostgreSQL con pgvector para la recuperación, Redis para la caché, FastAPI para la API, Docker y Kubernetes para el despliegue, y MLflow para la evaluación. Eso es una arquitectura empresarial, no otro chatbot.
Fuentes
- AI Board, AI Models for Executives 2026, informe de investigación publicado el 8 de septiembre de 2026 y actualizado el 26 de octubre de 2026: la tabla de buques insignia, las listas de lanzamientos y retiradas, precios, ventanas de contexto y rutas UE, cada línea con la fuente del propio proveedor. Leído el 6 de noviembre de 2026.
- Microsoft Learn, Foundry Models sold by Azure (página fechada el 21 de septiembre de 2026, actualizada el 29 de octubre de 2026): la entrada de Microsoft-Decision-1, y la guía de la Azure OpenAI Decisions API (21 de octubre de 2026).
- Microsoft, Microsoft-Decision-1: Our model for fast decision-making, anuncio del 9 de octubre de 2026: modelo base, precio, afirmaciones de latencia y precisión.
- Páginas de modelo de los proveedores leídas el 6 de noviembre de 2026 para los lanzamientos de septiembre y octubre: OpenAI (GPT-6.1 Terra), Anthropic (Claude Opus 5.5, Sonnet 5.5, Haiku 5.5), Google (Gemini 4 Argon), xAI (Grok 4.7), Meta (Muse Wonder, Muse Spark Open), DeepSeek (V4.1-Flash), Mistral (vista previa de Large 4), Alibaba (Qwen3.8-Max, Qwen3.8-27B), con las fichas de modelo en Hugging Face para los tamaños y licencias de pesos abiertos.
- Mis propias notas de estudio de noviembre de 2026 sobre el posicionamiento por caso de uso, las señales de enrutado, el pipeline de facturas y la ruta de aprendizaje, escritas a partir de los proyectos de este sitio. El posicionamiento es mi lectura, no una medición; los precios y la disponibilidad cambian cada mes y las páginas de los proveedores son la fuente de verdad.
Preguntas que responde
¿Cuál es el mejor LLM en 2026?
Ninguno es el mejor para todo. A 6 de noviembre de 2026 los buques insignia son GPT-6 Astra (OpenAI), Claude Fable 5.1 (Anthropic), Gemini 4 Argon (Google), Grok 4.7 (xAI), Muse Wonder (Meta), DeepSeek-V4-Pro, Mistral Medium 3.5 y Qwen3.8-Max. El adecuado depende de la tarea, la norma de residencia de datos, el presupuesto y tu propia evaluación con tus propios documentos.
¿Qué diferencia hay entre un modelo de pesos abiertos y uno de código abierto?
Un modelo de pesos abiertos publica los pesos entrenados para que puedas descargarlo y ejecutarlo; los datos de entrenamiento y el código suelen quedar cerrados, y la licencia puede limitar el uso comercial. Qwen3.8-27B y Muse Glimmer 30B son Apache-2.0, DeepSeek-V4 es MIT, Mistral Medium 3.5 usa una licencia MIT modificada con excepciones por ingresos, Qwen3.8-Max una licencia propia.
¿Qué modelo es mejor para agentes de programación?
Claude es la familia por la que la mayoría de los equipos empieza en el trabajo agéntico sobre software (Claude Opus 5.5 y Sonnet 5.5), con GPT-6 Sol y GPT-6.1 Terra como segundo candidato habitual y DeepSeek o Qwen3-Coder cuando el código debe quedarse en tus propias GPU.
¿Qué modelo debo usar para RAG?
Cualquier modelo actual de gama media responde bien sobre pasajes recuperados: Claude Sonnet 5.5, GPT-6.1 Terra, Gemini 3.8 Flash o Qwen3.8-Flash. La calidad de la recuperación importa más que el modelo, así que construye primero el conjunto de pruebas y compara dos candidatos sobre él.
¿Puedo ejecutar un LLM en un portátil con una GPU de 16 GB?
Los modelos de hasta unos 8 mil millones de parámetros van holgados; 14 mil millones funciona con cuantización a 4 bits y un contexto modesto; 32 mil millones necesita cuantización fuerte o descarga a CPU; 70 mil millones no cabe en la memoria de la GPU. La inferencia en producción va en servidores GPU dedicados con vLLM o SGLang.
¿Qué es Microsoft Decision-1 y es un LLM?
Es un modelo de puntuación de decisiones que Microsoft anunció el 9 de octubre de 2026, postentrenado a partir de Qwen3.5-9B. No genera texto: le das un texto y un conjunto fijo de opciones y devuelve una probabilidad calibrada por opción, a 0,042 $ por millón de tokens de entrada con salida gratuita. Úsalo para clasificar, enrutar, priorizar y calificar, no para escribir.
¿API propietaria o pesos abiertos autoalojados?
Empieza por una API salvo que una norma lo prohíba: sin GPU que operar, los modelos más potentes, cambio fácil detrás de una capa de abstracción. Autoaloja cuando los datos deben quedarse en hardware que controlas, cuando haces ajuste fino, o cuando el volumen es tan alto y predecible que alquilar GPU sale mejor que la factura por tokens. Muchos sistemas hacen las dos cosas.
¿Cómo evito que la retirada de un modelo me rompa el sistema?
Mantén una lista de cada nombre de modelo que llama tu código con un responsable por nombre, suscribe a esos responsables a las páginas de obsolescencia de OpenAI, Anthropic y Google Cloud, vuelve a pasar tu conjunto de evaluación por el sucesor antes de la fecha de apagado, y enruta a través de una sola abstracción para que un nombre de modelo se cambie en un solo sitio.
¿Por qué Meta sustituyó Llama por Muse?
En la primavera de 2026 Meta lanzó Muse Spark como su primer modelo de frontera sin pesos abiertos, después Muse Wonder el 12 de octubre de 2026 y, el 15 de octubre, Muse Spark Open con pesos abiertos. Los pesos de Llama 4 siguen descargables bajo la licencia comunitaria de Llama 4; la línea Llama sigue siendo la que ejecutan la mayoría de los despliegues autoalojados.
Etiquetas:llmopenaiclaudegeminigrokqwendeepseekllamamistralmicrosoft decision-1ai agentsmodel routing
Proyectos relacionados
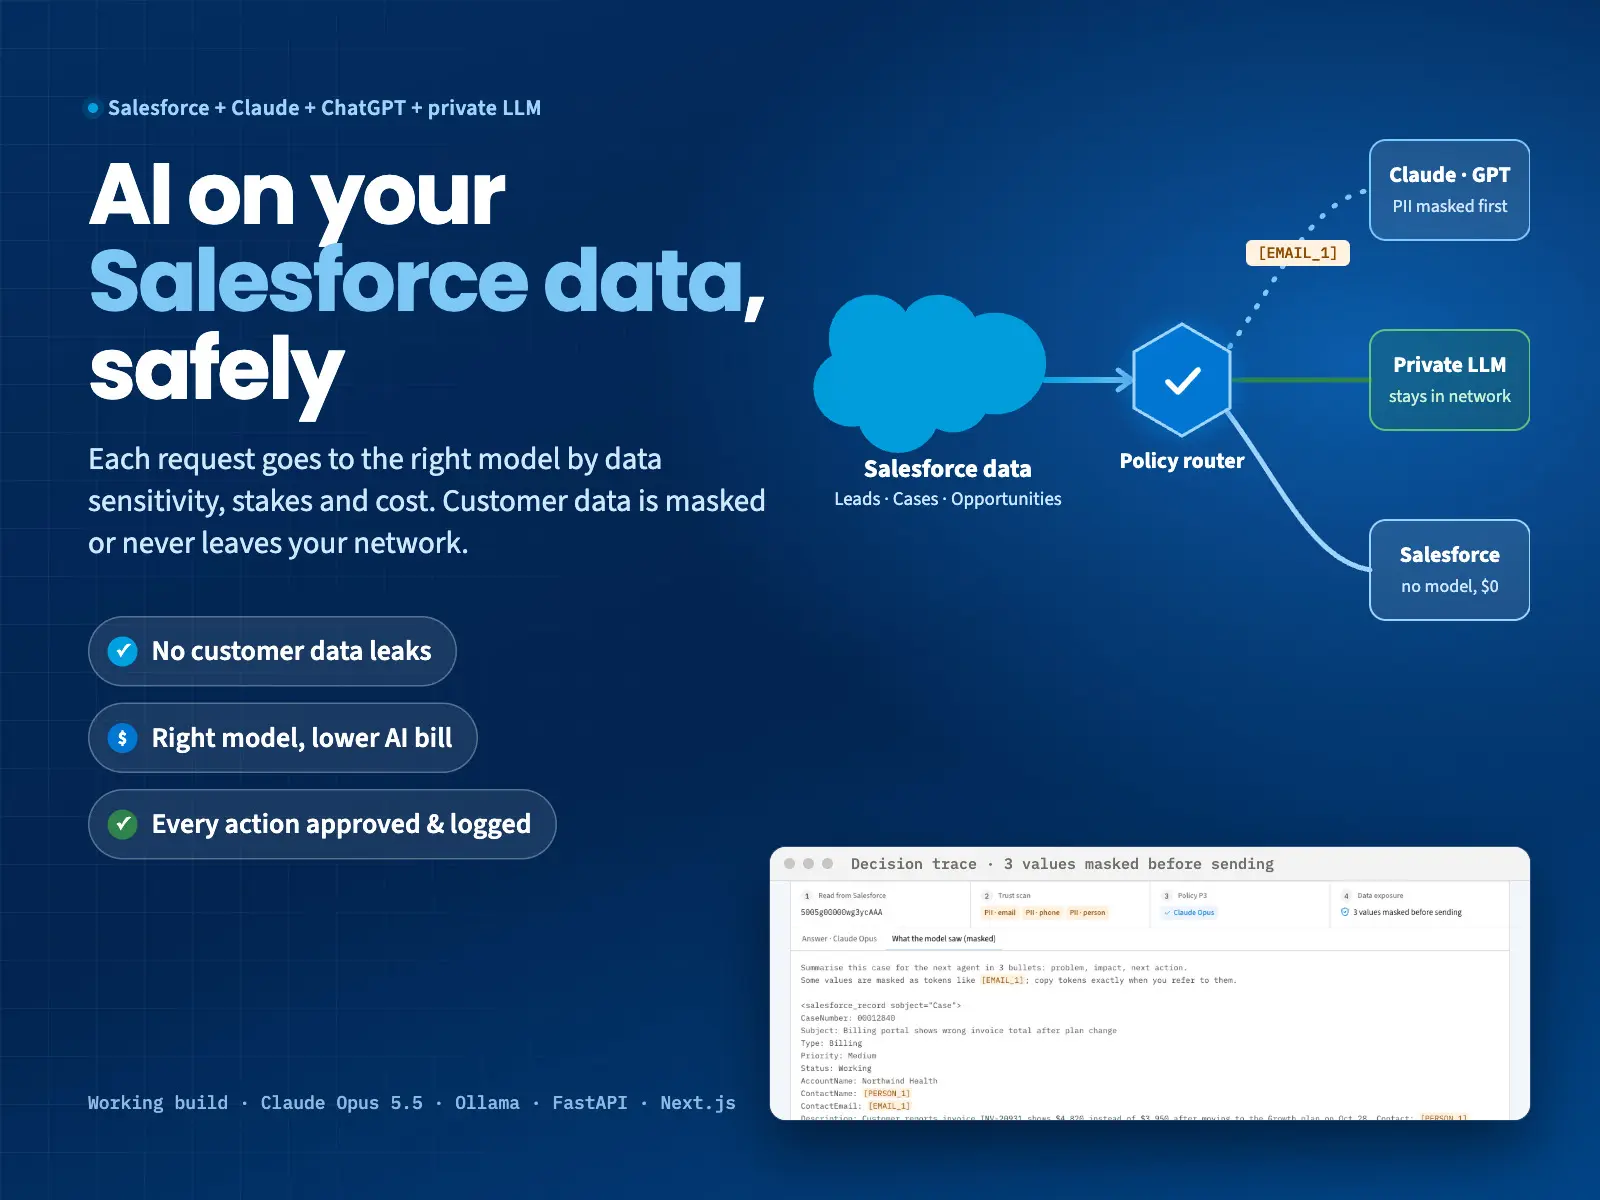
IA híbrida para Salesforce: Claude, ChatGPT y LLM privados, un router
IA y agentes · ERP y SaaS con IA · Seguridad y cumplimiento
Lakehouse AI Studio para Databricks: pipelines, RAG y agentes de IA
Bases de datos e ingeniería de datos · IA y agentes · Cloud, DevOps y LLMOps
Azure AI Automation: Document Intelligence, RAG y agentes gobernados
IA y agentes · Cloud, DevOps y LLMOps · Bases de datos e ingeniería de datos
¿Necesitas construir algo así? Mira mis Servicios · Portfolio