
AI Engineering
Microsoft Decision-1: qué es un modelo de decisión y cuándo usarlo
Por David Gadyan · Publicado el · 16 min de lectura
Microsoft anunció Decision-1 el 9 de octubre de 2026: un modelo postentrenado a partir de Qwen3.5-9B que no genera texto. Le das un texto y un conjunto fijo de opciones y devuelve una probabilidad calibrada por opción, en una pasada, a 0,042 $ por millón de tokens de entrada con salida gratuita. Este artículo explica la diferencia con un modelo de lenguaje, los tres tipos de pregunta, qué afirma Microsoft y qué está verificado, los casos de uso en los que sustituye a una llamada a un LLM, dónde se coloca en un bucle de agente, qué cuesta a escala y sus límites.
La mayoría de las llamadas dentro de una aplicación de IA no son peticiones de prosa. Son decisiones: a qué cola va este ticket, si esta llamada a herramienta es segura, si esta respuesta generada cumple la rúbrica, cuál de cuatro acciones viene después. Los equipos venían tomando esas decisiones con un modelo de lenguaje y una expresión regular sobre su salida, pagando precios de buque insignia por un sí o un no.
Microsoft Decision-1, anunciado el 9 de octubre de 2026, es la respuesta de Microsoft a ese despilfarro: un modelo que puntúa un conjunto fijo de opciones y devuelve una probabilidad por cada una, sin generar texto. Este artículo explica qué significa eso, en qué se diferencia de un gran modelo de lenguaje, qué afirma Microsoft y qué está verificado, y los casos de uso en los que encaja. Es el complemento de ¿Qué LLM usar?, donde Decision-1 aparece como una de nueve familias de modelos, y reutiliza los patrones de agente y evaluación de mi proyecto de inteligencia documental en Azure.
La respuesta corta
Decision-1 es un modelo de decisión, no un chatbot. Dale un texto (el estado) y un conjunto de preguntas con respuestas fijas, y devuelve una probabilidad calibrada por respuesta en una pasada: sí/no, una de varias opciones, o una posición en una escala ordenada. Está postentrenado a partir de Qwen3.5-9B, acepta hasta 32.768 tokens de texto, cuesta 0,042 $ por millón de tokens de entrada con salida gratuita, y corre en Microsoft Foundry y en OpenRouter. Úsalo para enrutar, clasificar, priorizar, controlar agentes y calificar. Usa un modelo de lenguaje cuando la respuesta haya que escribirla.
| Dato | Valor, según lo publica Microsoft |
|---|---|
| Anuncio | 9 de octubre de 2026, blog Microsoft Command Line; disponible de forma general en Microsoft Foundry |
| Modelo base | Qwen3.5-9B, postentrenado para puntuar decisiones en una sola pasada; Microsoft dice que lo reconstruirá sobre otros modelos, incluidos MAI y OpenAI |
| Qué devuelve | Una puntuación de probabilidad calibrada por cada opción de respuesta suministrada; sin texto, sin justificación |
| Formatos de pregunta | Sí/no, opción múltiple, valoración, clasificación y preguntas con rúbrica |
| Entrada | Hasta 32K tokens de texto; sin imagen, audio ni vídeo |
| Precio | 0,042 $ por millón de tokens de entrada; tokens de salida gratuitos |
| Dónde | Microsoft Foundry (vendido directamente por Azure, facturado en la suscripción de Azure) y OpenRouter |
| Pesos | No se distribuyen |
¿Qué diferencia hay entre un modelo de decisión y un LLM?
Un modelo de lenguaje genera una respuesta token a token; un modelo de decisión evalúa opciones que tú le das y las puntúa. La diferencia está en el contrato, no en la inteligencia. Con un LLM escribes "analiza esta queja y di qué deberíamos hacer", recibes un párrafo y lo interpretas, esperando que el formato se mantenga. Con un modelo de decisión envías la queja más las opciones "reembolso, reposición del pedido, escalar, no hacer nada", y recibes una probabilidad por cada una. La Figura 1 muestra los dos flujos sobre la misma entrada.
| Aspecto | Gran modelo de lenguaje | Decision-1 |
|---|---|---|
| Entrada | Un prompt, texto libre, opcionalmente imágenes | Un estado de texto más preguntas con opciones fijas |
| Salida | Texto generado, o JSON mediante salidas estructuradas | Una probabilidad por opción; una opción seleccionada en las preguntas de elección |
| Explicación | Puede escribir una justificación | Ninguna, por diseño |
| Latencia | Segundos en la gama alta; la longitud de la salida manda | Milisegundos: una pasada, sin tokens de salida (Microsoft informa de una mediana unas 35 veces menor que GPT-6 Sol) |
| Coste | De 0,20 a 10 $ por millón de tokens de entrada más la salida | 0,042 $ por millón de tokens de entrada, salida gratuita |
| Calibración | Un "confianza: 0,8" en texto generado es una conjetura | La probabilidad forma parte de la API; el objetivo de Microsoft es que una predicción del 90 por ciento acierte unas nueve de cada diez veces en casos representativos |
| Mejor para | Escribir, resumir, extraer, planificar, programar | Clasificar, enrutar, priorizar, verificar, calificar |
| Modo de fallo | Contenido alucinado, deriva de formato | Mala calibración en entradas distintas al benchmark; abstención o rechazo disponibles |
¿Cómo funciona la API de Decision-1?
La petición tiene tres partes: el texto a puntuar, las preguntas y el nombre del despliegue. Cada pregunta tiene un tipo, instrucciones y las respuestas permitidas. Microsoft Learn documenta tres tipos en la Decisions API de Foundry, y la entrada de Decision-1 en el catálogo lista las mismas formas con otros nombres: sí/no, opción múltiple y valoración.
| Tipo de pregunta | Pídele que | Resultado principal |
|---|---|---|
| Predicado (sí/no) | Compruebe si una condición es cierta: "¿Pide el cliente un reembolso?" | Una probabilidad de 0 a 1 de que la condición sea cierta |
| Elección (opción múltiple) | Seleccione una opción sin orden: un departamento, una categoría de contenido | El valor elegido, una probabilidad por opción y una confianza aparte |
| Puntuación (valoración) | Valore una entrada contra niveles ordenados: gravedad de una incidencia, calidad de una respuesta | Una probabilidad por nivel y la media ponderada por probabilidad de los índices de nivel |
Esta es la forma de una pregunta de elección y de su respuesta en la Decisions API de Foundry, tal como la documenta Microsoft Learn el 21 de octubre de 2026. Los valores son ilustrativos, como en el propio ejemplo de Microsoft.
{
  "model": "TU-NOMBRE-DE-DESPLIEGUE",
  "input": "Me han cobrado dos veces el pedido.",
  "questions": [
    {
      "type": "choice",
      "name": "departamento",
      "instructions": "¿Qué departamento debe atender esta queja?",
      "choices": [
        { "value": "facturacion", "description": "Pagos y reembolsos." },
        { "value": "tecnico", "description": "Problemas del producto." },
        { "value": "envios", "description": "Entrega y seguimiento." },
        { "value": "otro", "description": "Cualquier otra petición." }
      ]
    }
  ]
}
{
  "type": "choice",
  "name": "departamento",
  "choice": "facturacion",
  "probabilities": [
    { "value": "facturacion", "probability": 0.95 },
    { "value": "tecnico", "probability": 0.02 },
    { "value": "envios", "probability": 0.01 },
    { "value": "otro", "probability": 0.02 }
  ],
  "confidence": 0.93
}
Cuatro reglas de la documentación que ahorran una semana de depuración:
- Dale a cada pregunta un nombre único. El array de respuestas vuelve en el mismo orden, y el nombre es como las emparejas.
- Pon las preguntas independientes en una sola petición. Varias preguntas sobre el mismo texto son una llamada; una pregunta que depende de una respuesta anterior es una segunda llamada.
- Incluye una opción de reserva como "otro" o "no se puede saber" cuando las categorías no cubran todas las entradas, y trata un rechazo como algo distinto de una probabilidad baja.
- Elige cada umbral con ejemplos etiquetados de tu propia aplicación, según el coste de un falso positivo y de un falso negativo en ese escenario.
La guía de Microsoft Learn de la Decisions API usa el modelo gpt-6-luna y el endpoint /openai/v1/decisions; Decision-1 se despliega desde el catálogo de Foundry como modelo propio, con los mismos tres tipos de pregunta. Comprueba la entrada del catálogo para el endpoint exacto de tu despliegue.
¿Qué afirma Microsoft, y qué está verificado de forma independiente?
Todo lo que sigue procede del anuncio de Microsoft y de sus páginas de Learn. Nada había sido reproducido por una evaluación independiente a 6 de noviembre de 2026, y los análisis de terceros señalan que el catálogo de Foundry describe la metodología de los benchmarks sin publicar cifras. Lee la tabla como las afirmaciones del proveedor.
| Afirmación | Cifra de Microsoft | Estado |
|---|---|---|
| Latencia mediana | Unas 35 veces menor que GPT-6 Sol; 2,5 veces menor que el segundo, H2O-Lightning-4B v1.1 | Medición del proveedor a través de Foundry |
| Precisión | La más alta en una comparación de 36 benchmarks con casi 150.000 preguntas | Medición del proveedor; la lista de benchmarks no se publica con cifras |
| Robustez | Cambia su decisión en el 1,3 por ciento de las perturbaciones de media; cero cambios cuando se parafrasean las descripciones de las opciones | Medición del proveedor |
| Pruebas de seguridad | 5.250 peticiones en 11 benchmarks | Medición del proveedor |
| Calibración | La probabilidad forma parte de la API, con el objetivo de que una predicción del 90 por ciento acierte unas nueve de cada diez veces | Objetivo de diseño; sin cifra de calibración publicada |
| Xbox Research | Competitivo en calidad con GPT-6 Sol siendo más de 14 veces más rápido y 200 veces más barato | Caso de uso interno de Microsoft |
| Copilot | Competitivo con GPT-5.6 Luna y 100 veces más rápido | Caso de uso interno de Microsoft |
| Microsoft Discovery | 46 veces más consistente que la puntuación basada en LLM a tres veces la velocidad | Caso de uso interno de Microsoft |
| Precio | 0,042 $ por millón de tokens de entrada, salida gratuita | Publicado |
La lectura honesta: el argumento de arquitectura es sólido y el precio es real, y los números de calidad son lo que debes medir tú mismo con unos cientos de ejemplos etiquetados antes de fiarte de un umbral.
¿Cuándo usar Decision-1 en vez de un LLM?
Hazte una pregunta: ¿puedes enumerar todas las respuestas aceptables antes de la llamada? Si sí, y no necesitas una explicación escrita, un modelo de decisión encaja. Si la respuesta hay que escribirla, resumirla o explicarla, no.
| Problema | Modelo de lenguaje | Decision-1 |
|---|---|---|
| Escribir un correo a un cliente | Excelente | No adecuado |
| Explicar un informe financiero | Excelente | No adecuado |
| Generar código Python | Excelente | No adecuado |
| Extraer campos a tu propio esquema JSON | Excelente, con salidas estructuradas | No adecuado |
| Clasificar el sentimiento de un cliente | Bueno | Encaje excelente |
| Enrutar una petición al agente o departamento correcto | Bueno | Encaje excelente |
| Priorizar tickets de soporte | Bueno | Encaje excelente |
| Seleccionar la siguiente acción de una lista fija | Bueno | Encaje excelente |
| Calificar una respuesta generada por IA contra una rúbrica | Bueno, con justificación | Encaje excelente para la puntuación |
| Comprobar si una llamada a herramienta está dentro de la política | Bueno, lento | Encaje excelente |
| Etiquetar un conjunto de datos con una taxonomía fija | Bueno, caro con volumen | Encaje excelente |
| Filtrado de contenido y cribado de seguridad | Bueno | Encaje excelente |
La conclusión de arquitectura es la misma que recorre la comparación de LLM: un agente puede tomar treinta decisiones en una ejecución, y la mayoría no necesita un modelo de razonamiento. Un modelo de decisión ligero se encarga de los controles y las comprobaciones; el modelo potente, de la planificación y la redacción.
¿Dónde se coloca un modelo de decisión en un sistema real?
La Figura 2 muestra los tres sitios donde yo lo pongo: triaje de soporte, un bucle de agente y un pipeline de evaluación. Toca una capa para leer qué pasa en ella.
Cada ticket se puntúa una vez: si es urgente, qué departamento, cuánta frustración hay. Un modelo de lenguaje solo redacta la respuesta, y solo para los tickets que la necesitan.
El texto del ticket es el estado que puntúa el modelo; la ficha del cliente puede añadirse como contexto.
Tres preguntas en una llamada: ¿urgente? (sí/no), departamento (elección), frustración (puntuación). Cada respuesta es una probabilidad por opción.
Los umbrales que elegiste con tickets etiquetados deciden la cola; todo lo que queda por debajo va a una persona.
Un modelo de lenguaje de gama media redacta la respuesta con la política recuperada; es el único paso que genera texto.
Una pregunta con rúbrica califica el borrador: ¿se apoya en la política? ¿es cortés? ¿está completo? Las puntuaciones bajas vuelven atrás o a una persona.
Las personas ven los casos inciertos y las muestras que auditas; sus etiquetas alimentan la siguiente revisión de umbrales.
Uso típico: Centros de soporte, buzones compartidos, formularios y cualquier cola donde miles de elementos al día necesitan las mismas pocas etiquetas.
Toca una capa para leer qué hace esa tecnología en esta pila.
| Capa | Tecnología | Qué hace |
|---|---|---|
| Entrada | Email, chat, web form | El texto del ticket es el estado que puntúa el modelo; la ficha del cliente puede añadirse como contexto. |
| Modelo de decisión | Microsoft Decision-1 | Tres preguntas en una llamada: ¿urgente? (sí/no), departamento (elección), frustración (puntuación). Cada respuesta es una probabilidad por opción. |
| Enrutado | Queue per department, SLA timers | Los umbrales que elegiste con tickets etiquetados deciden la cola; todo lo que queda por debajo va a una persona. |
| Redacción de la respuesta | GPT-6.1 Terra, Claude Sonnet 5.5 | Un modelo de lenguaje de gama media redacta la respuesta con la política recuperada; es el único paso que genera texto. |
| Control de calidad | Microsoft Decision-1 | Una pregunta con rúbrica califica el borrador: ¿se apoya en la política? ¿es cortés? ¿está completo? Las puntuaciones bajas vuelven atrás o a una persona. |
| Personas | Agent review | Las personas ven los casos inciertos y las muestras que auditas; sus etiquetas alimentan la siguiente revisión de umbrales. |
| Capa | Tecnología | Qué hace |
|---|---|---|
| Tarea | User goal | La tarea en lenguaje natural, más el contexto que el agente puede ver. |
| Planificación | Claude Opus 5.5, GPT-6 Sol | El modelo de razonamiento decide qué hacer a continuación y redacta la llamada a la herramienta. |
| Control previo a la acción | Microsoft Decision-1 | ¿Está la llamada dentro de la política? ¿Es una escritura? ¿Necesita aprobación? Tres preguntas de sí/no, puntuadas en una pasada antes de ejecutar nada. |
| Herramientas | MCP tools, APIs and databases | El mismo registro de herramientas sirve al agente y a los clientes MCP; los permisos son por rol. |
| Comprobación posterior | Microsoft Decision-1 | ¿Ha tenido éxito el paso? Continuar, reintentar o escalar: una pregunta de elección sobre la salida de la herramienta. |
| Estado | PostgreSQL, Redis | Puntos de control del bucle, para que una ejecución pueda pausarse ante una persona y reanudarse. |
| Observabilidad | OpenTelemetry traces, MLflow | Cada decisión, sus probabilidades y su coste acaban en una traza por ejecución. |
| Capa | Tecnología | Qué hace |
|---|---|---|
| Elementos a calificar | Model outputs or raw records | Respuestas del modelo candidato, o registros sin etiquetar que esperan una categoría. |
| Rúbrica | Ordered levels with criteria | Cada nivel tiene criterios observables; los niveles contiguos deben diferir con claridad, o las probabilidades se difuminan. |
| Puntuación | Microsoft Decision-1 | Una pregunta de puntuación devuelve una probabilidad por nivel y una puntuación ponderada; una pregunta de elección devuelve la etiqueta. |
| Justificación muestreada | LLM judge, Human audit | Una muestra pequeña recibe una explicación escrita de un modelo de lenguaje y una comprobación humana, para detectar deriva en la propia rúbrica. |
| Seguimiento | MLflow, Dashboards | Puntuaciones por versión de modelo, por versión de prompt y por conjunto de documentos, lado a lado. |
| Realimentación | Prompt and threshold updates | Rúbrica, umbrales y prompts cambian con evidencia; el mismo conjunto se vuelve a ejecutar antes de cada actualización. |
El bucle de agente es el que más cambia la economía, así que la Figura 3 lo dibuja completo.
El patrón en palabras:
- Planificar. Un modelo de razonamiento (Claude Opus 5.5, GPT-6 Sol) lee la tarea y redacta la siguiente llamada a herramienta.
- Controlar. Decision-1 responde tres preguntas de sí/no sobre el borrador: dentro de la política, acción de escritura, necesita aprobación humana. Los umbrales salen de ejemplos etiquetados; cualquier duda espera a una persona.
- Actuar. La llamada a herramienta corre por el mismo registro que sirve a los clientes MCP, con permisos por rol.
- Comprobar. Decision-1 puntúa la salida de la herramienta con una pregunta de elección: continuar, reintentar o escalar.
- Registrar. El estado va a un punto de control en PostgreSQL o Redis para que la ejecución pueda pausarse y reanudarse, y cada decisión con sus probabilidades y su coste acaba en la traza de OpenTelemetry.
Es el mismo agente con aprobación que construí en el proyecto de inteligencia documental en Azure; la diferencia es que entonces los controles eran llamadas a un modelo de lenguaje, y un modelo de decisión los hace más baratos y más consistentes.
¿Qué cuesta a escala?
Aritmética a precio de lista, no un presupuesto. Tres cargas de trabajo, cada una con sus supuestos declarados, comparadas con los mismos tokens en GPT-6.1 Terra a 1 $ por millón de tokens de entrada (sin contar la salida, lo que favorece al LLM).
| Carga de trabajo | Supuestos | Decision-1 al mes | GPT-6.1 Terra solo entrada, al mes |
|---|---|---|---|
| Triaje de soporte | 10.000 tickets al día, 1.500 tokens cada uno, 3 preguntas en una llamada | 450M tokens, unos 19 $ | unos 450 $ más la salida |
| Controles y comprobaciones de agente | 2.000 ejecuciones al día, 30 pasos, 2 decisiones por paso, 2.000 tokens cada una | 7.200M tokens, unos 302 $ | unos 7.200 $ más la salida |
| Evaluación | 100.000 respuestas calificadas a la semana, 3.000 tokens cada una | 1.200M tokens, unos 50 $ | unos 1.200 $ más la salida |
La proporción es lo importante: con el mismo número de tokens el modelo de decisión cuesta alrededor del 4 por ciento del precio de entrada de un modelo de lenguaje de gama media, y no produce ningún token de salida. La latencia se mueve igual, de segundos a milisegundos, que es lo que hace aceptables treinta controles por ejecución de agente.
¿Cuáles son los límites?
- Sin explicación. El modelo devuelve probabilidades y nada más. Cuando un usuario o un auditor necesite una justificación, añade una llamada a un modelo de lenguaje para los casos muestreados.
- Solo texto, 32K tokens. Sin imágenes, audio ni vídeo; los documentos largos hay que trocearlos o resumirlos antes. Para imágenes, la Decisions API de Foundry con gpt-6-luna ofrece los mismos tipos de pregunta.
- Pesos cerrados. Sin descarga, ajuste fino, cuantización ni autoalojamiento. Si lo necesitas, el modelo base Qwen3.5-9B es abierto, y un clasificador entrenado con tus etiquetas sigue siendo la opción clásica.
- Solo benchmarks del proveedor. Las cifras de velocidad, precisión y calibración son las de Microsoft a 6 de noviembre de 2026.
- Una base que se mueve. Microsoft planea reconstruir Decision-1 sobre otros modelos; conserva el conjunto etiquetado y repítelo en cada versión, como harías ante cualquier retirada de modelo.
- No para decisiones trascendentes sobre personas. La ficha del modelo descarta que sea la única base en crédito, empleo, vivienda, seguros, educación, sanidad y derechos legales.
- Los umbrales son tuyos. Una probabilidad solo sirve con un umbral que elegiste con tus propios datos, y una probabilidad máxima baja significa una persona, no una moneda al aire.
¿Cómo se fijan los umbrales?
- Reúne entre 200 y 500 ejemplos etiquetados por pregunta a partir del tráfico real, incluidos los feos.
- Pásalos por la pregunta tal como está escrita, y guarda la probabilidad por opción.
- Dibuja precisión y exhaustividad frente al umbral para cada opción, y elige el punto en el que el coste de un falso positivo y el de un falso negativo se equilibran en ese escenario.
- Define la banda de escalado: todo lo que quede entre los umbrales, más los rechazos, va a una persona.
- Vigila la deriva cada semana: la proporción de escalados, la coincidencia con las etiquetas humanas en una muestra y la distribución de las probabilidades máximas. Un cambio significa que cambiaron las entradas o la versión del modelo.
- Repite el conjunto en cada versión nueva del modelo antes de cambiar el despliegue.
¿Qué servicio elegir para una decisión?
La Figura 4 es la guía de tres preguntas. Termina en Decision-1 más veces de las que esperarías, y en un modelo de lenguaje siempre que la respuesta haya que escribirla.
| Necesidad | Primera opción | Por qué |
|---|---|---|
| Opciones fijas, texto, alto volumen | Microsoft Decision-1 | Probabilidad calibrada, milisegundos, 0,042 $ por millón |
| Opciones fijas sobre texto e imágenes | Decisions API con gpt-6-luna en Microsoft Foundry | Las mismas preguntas de predicado, elección y puntuación, entrada de imágenes, precios de modelo de lenguaje |
| Tu propio esquema JSON o una explicación escrita | Un modelo de lenguaje con salidas estructuradas (Responses API) | La respuesta hay que generarla |
| Opciones fijas, con autoalojamiento obligatorio | Un clasificador ajustado con tus etiquetas, o un modelo abierto como Qwen3.5-9B con puntuación por log-probabilidades | Pesos que controlas; la calibración es cosa tuya |
Fuentes
- Microsoft, Microsoft-Decision-1: Our model for fast decision-making, Achint Srivastava, 9 de octubre de 2026: modelo base, tipos de pregunta, objetivo de calibración, comparaciones de latencia y precisión, casos de uso internos, precio y disponibilidad. Leído el 6 de noviembre de 2026.
- Microsoft Learn, Foundry Models sold by Azure, página fechada el 21 de septiembre de 2026 y actualizada el 29 de octubre de 2026: la fila de Microsoft-Decision-1 (decisión, clasificación de texto, clasificación sin ejemplos; puntuación de decisiones calibrada; preguntas de sí/no, opción múltiple, valoración, clasificación y rúbrica; puntuación en una sola pasada sobre entradas de hasta 32K tokens; solo texto; sin explicaciones).
- Microsoft Learn, guía de la Azure OpenAI Decisions API, página fechada el 21 de octubre de 2026: los tipos de pregunta predicado, elección y puntuación, las formas de petición y respuesta, los rechazos y las indicaciones sobre umbrales.
- Catálogo de Microsoft Foundry, Microsoft-Decision-1: la opción de abstención y la restricción sobre decisiones trascendentes sobre personas. El catálogo se abre dentro del portal de Foundry con sesión iniciada; esos dos puntos están tal como los citan los análisis de abajo, así que compruébalos en tu propio tenant.
- OpenRouter, microsoft/microsoft-decision-1: el listado del 9 de octubre de 2026 con el mismo precio.
- Análisis de terceros leídos el 6 de noviembre de 2026 para el estado de la verificación independiente (sin cifras de benchmark publicadas en la entrada del catálogo; pesos no distribuidos): eesel.ai y Orca Router. Sus números no se usan aquí.
- Mis propias notas de estudio de noviembre de 2026 sobre la tabla de casos de uso, el bucle de agente, la aritmética de costes y el procedimiento de umbrales, escritas a partir de los proyectos de este sitio. Las cifras de coste son aritmética a precio de lista sobre supuestos declarados, no presupuestos.
Preguntas que responde
¿Qué es Microsoft Decision-1?
Un modelo de puntuación de decisiones que Microsoft anunció el 9 de octubre de 2026 y lista en Microsoft Foundry como disponible de forma general. Está postentrenado a partir de Qwen3.5-9B para puntuar decisiones en una sola pasada: dado un texto y un conjunto fijo de opciones de respuesta devuelve una probabilidad calibrada por opción, sobre entradas de hasta 32.768 tokens, y no genera texto.
¿Decision-1 es un LLM?
Está construido a partir de uno, un modelo Qwen3.5 de 9 mil millones de parámetros, pero no se usa como tal. Un modelo de lenguaje genera texto token a token; Decision-1 puntúa opciones en una sola pasada y devuelve probabilidades, así que no hay tokens de salida, ni justificación, ni nada que interpretar.
¿Cuánto cuesta Microsoft Decision-1?
0,042 $ por millón de tokens de entrada, y los tokens de salida son gratuitos, según el anuncio de Microsoft del 9 de octubre de 2026. Lo vende directamente Azure en Microsoft Foundry, facturado en la suscripción de Azure, y está listado en OpenRouter.
¿Qué diferencia hay entre un modelo obsoleto y uno retirado, y aplica aquí?
Obsoleto significa que se ha anunciado una fecha de fin y el modelo sigue respondiendo; retirado significa que todas las llamadas fallan. Decision-1 se lanzó en octubre de 2026 y no tiene fecha de fin anunciada, pero Microsoft dice que lo reconstruirá sobre otras bases, incluidos modelos de Microsoft AI y de OpenAI, así que conserva tu conjunto de evaluación para repetirlo en cada versión.
¿Qué tipos de pregunta admite Decision-1?
Preguntas de sí/no que devuelven una probabilidad de 0 a 1, preguntas de opción múltiple que devuelven una opción más una probabilidad por opción, preguntas de valoración sobre niveles ordenados, y calificación con rúbrica de respuestas de IA y acciones de agentes. Varias preguntas sobre el mismo texto caben en una petición, y el modelo puede abstenerse con una opción como "no se puede saber".
¿Cuándo debo usar Decision-1 en vez de GPT o Claude?
Cuando puedas enumerar de antemano todas las respuestas aceptables y no necesites una explicación escrita: clasificar un ticket, enrutar una petición a un agente, priorizar una cola, decidir si una llamada a herramienta necesita aprobación, calificar una respuesta generada contra una rúbrica. Cuando la respuesta haya que escribirla, resumirla o explicarla, usa un modelo de lenguaje.
¿Las afirmaciones de velocidad y precisión están verificadas de forma independiente?
No a 6 de noviembre de 2026. La latencia mediana unas 35 veces menor que GPT-6 Sol, la mayor precisión en 36 benchmarks y casi 150.000 preguntas, y el 1,3 por ciento de cambios de decisión ante perturbaciones son mediciones del propio Microsoft a través de Foundry. Los análisis de terceros señalan que el catálogo de Foundry publica la metodología pero no las cifras.
¿Puedo descargar los pesos de Decision-1?
No. Los pesos no se distribuyen, así que no hay autoalojamiento, ni ajuste fino, ni variante cuantizada. El acceso es a través de Microsoft Foundry u OpenRouter. Si necesitas un modelo de decisión autoalojado, la base, Qwen3.5-9B, es de pesos abiertos, y un clasificador pequeño ajustado con tus etiquetas es la alternativa clásica.
¿Decision-1 puede leer imágenes?
No, es solo texto y no acepta ni produce imagen, audio ni vídeo. En Microsoft Foundry la Decisions API con el modelo gpt-6-luna ofrece los mismos tres tipos de pregunta sobre texto e imágenes, a precios de modelo de lenguaje.
Etiquetas:microsoft decision-1microsoft foundrydecision modelllmai agentsclassificationmodel routingllm evaluation
Proyectos relacionados
Lakehouse AI Studio para Databricks: pipelines, RAG y agentes de IA
Bases de datos e ingeniería de datos · IA y agentes · Cloud, DevOps y LLMOps
CareLens: IA clínica en Kubernetes y Azure, lista para HIPAA
Cloud, DevOps y LLMOps · Seguridad y cumplimiento · IA y agentes
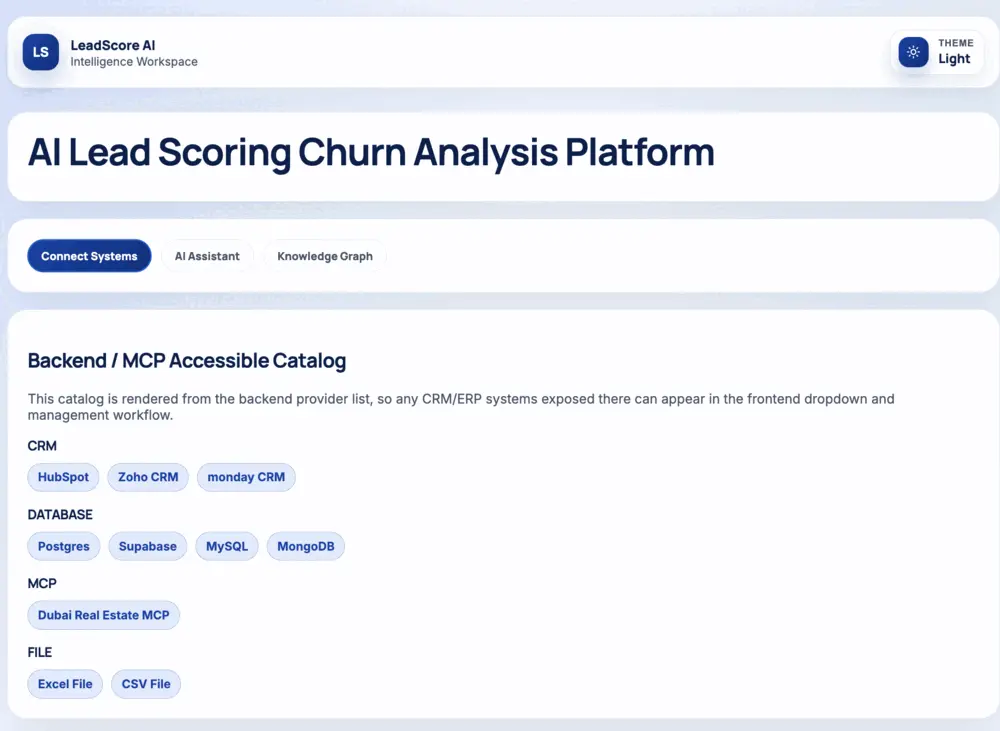
Motor de lead scoring y detección de churn con IA (S1mple.ai)
ERP y SaaS con IA · IA y agentes · Marketing con IA y analítica · Bases de datos e ingeniería de datos
¿Necesitas construir algo así? Mira mis Servicios · Portfolio