
Data Engineering
Snowflake vs Databricks: dónde coinciden los casos de uso y dónde se separan
Por David Gadyan · Publicado el · 15 min de lectura
Snowflake y Databricks resuelven el mismo problema desde extremos opuestos: uno nació de un almacén de datos SQL que te oculta los archivos; el otro, de Apache Spark y de tablas que viven como archivos en tus propios buckets. Este artículo alinea lo que comparten, hacia dónde se inclina cada uno, en qué se diferencian sus capas de IA y qué elegir para cada carga de trabajo.
En las últimas semanas terminé el curso de Coursera Intro to Snowflake for Devs, Data Scientists and Data Engineers, lo convertí en un mapa mental interactivo, construí una plataforma de datos con IA al estilo Snowflake y tracé cómo practicar el lado de Databricks en un portátil. La pregunta que surgió en todas las conversaciones fue la misma: ¿cuál deberíamos usar?
La respuesta honesta es que las dos plataformas se solapan más de lo que sugiere su marketing, y que las diferencias que quedan tienen que ver con desde dónde empiezas, no con lo que es posible. Este artículo las alinea por caso de uso. Los datos sobre Snowflake vienen del curso; los de Databricks, de la documentación de Databricks. Ambas plataformas cambian cada mes, así que toma las tablas como un mapa, no como un contrato.
Dos plataformas, dos puntos de partida
Snowflake nació como almacén de datos en la nube. El curso describe la separación entre almacenamiento y cómputo como "algo que Snowflake fue el primero en hacer" y enumera cuatro capas: almacenamiento optimizado, cómputo elástico multiclúster, servicios en la nube y Snowgrid. Creas almacenes, bases de datos y tablas en SQL; de los archivos, las microparticiones, el cifrado y los metadatos se encarga la plataforma.
Databricks nació con Apache Spark, el motor distribuido de código abierto que crearon sus fundadores. La plataforma combina el cómputo de Spark con Delta Lake, un formato de tabla que añade transacciones ACID, viaje en el tiempo y MERGE a los archivos Parquet, y con Unity Catalog para permisos, metadatos y linaje. Los archivos se quedan en tu propio almacenamiento de objetos; Databricks pone el espacio de trabajo, el cómputo y el catálogo.
Uno junto al otro
| Snowflake | Databricks | |
|---|---|---|
| Origen | Almacén de datos en la nube, SQL primero | Apache Spark, lakehouse con el código primero |
| Dónde viven los datos | Almacenamiento gestionado por Snowflake sobre objetos en la nube; Iceberg para tablas externas | Tu propio almacenamiento de objetos (S3, ADLS, GCS) como tablas Delta |
| Formato de tabla | Microparticiones gestionadas por la plataforma | Delta Lake: Parquet más un registro de transacciones |
| Unidad de cómputo | Almacén virtual, de XS a 6XL, suspensión y reanudación automáticas | Clústeres Spark y SQL warehouses, gestionados por Databricks |
| Lenguajes principales | SQL primero; Python, Java y Scala vía Snowpark | Python, SQL y Scala sobre Spark |
| Gobernanza | Control de acceso por roles, políticas de enmascarado y de acceso por filas | Unity Catalog: permisos, metadatos, linaje |
| Transformación programada | Tablas dinámicas, streams y tasks | Pipelines y jobs de Lakeflow |
| Aprendizaje automático | Funciones ML de Cortex, Snowpark ML, Model Registry, Feature Store | MLflow, notebooks, Mosaic AI y servicio de modelos |
| IA generativa | Funciones LLM de Cortex, Cortex Search, Cortex Analyst, ajuste fino | Mosaic AI, servicio de modelos |
| Apps | Streamlit en Snowflake, Native App Framework, Marketplace | Notebooks y dashboards en el espacio de trabajo |
| Compartición | Comparticiones sin copia, Marketplace, Data Clean Rooms | No cubierto en esta ronda de notas |
| Práctica gratuita | Cuenta de prueba, CLI, extensión de VS Code | Spark con Delta Lake en local, Free Edition |
Lo que comparten
Quita las marcas y las dos plataformas coinciden en la arquitectura que ganó la última década:
- Almacenamiento y cómputo están separados y se facturan por separado. Snowflake dimensiona los almacenes con independencia de las tablas; Databricks acopla clústeres a tablas que viven en tus buckets.
- SQL y Python son de primera clase en ambos. Snowflake tiene hojas SQL, DataFrames de Snowpark y Notebooks; Databricks tiene Spark SQL, PySpark y notebooks.
- Las tablas son transaccionales y tienen historial. El Time Travel de Snowflake consulta una tabla AT una marca de tiempo o BEFORE un id de consulta, con una retención por defecto de 1 día y hasta 90 días en Enterprise; Delta Lake ofrece escrituras ACID, viaje en el tiempo y MERGE INTO sobre archivos.
- Los datos se organizan por capas. El curso construye esquemas raw, harmonized y analytics; el lakehouse construye bronze, silver y gold. La misma idea con otros nombres.
- Un solo catálogo lo gobierna todo, incluidas las funciones de IA: los roles de Snowflake deciden también quién puede llamar a funciones de Cortex o abrir una app Streamlit; Unity Catalog hace lo mismo con los activos de Databricks.
- Las funciones LLM viven dentro de la plataforma y no en un servicio aparte, así que los datos no tienen que salir para que un modelo los use.
- Ambos corren en AWS, Azure y Google Cloud.
Dónde se separan los casos de uso
| Caso de uso | Se inclina a | Por qué |
|---|---|---|
| Dashboards de BI con muchos usuarios concurrentes | Snowflake | Los almacenes multiclúster añaden clústeres cuando muchos usuarios consultan a la vez y la caché de resultados sirve las consultas repetidas; la demo de Streamlit del curso lee una vista de más de 690 millones de filas con menos de 100 líneas de código |
| Grandes transformaciones a medida en código | Databricks | Los DataFrames de Spark y los notebooks son la forma nativa de trabajar; la plataforma nació exactamente de esto |
| Transformaciones programadas sin orquestador | Snowflake | Las tablas dinámicas se refrescan con el TARGET_LAG que elijas, lo que el curso llama "casi siempre la elección correcta" para transformaciones programadas con joins |
| Pipelines que ya corren en Airflow, Prefect o dbt | Cualquiera | Ambos aceptan un planificador externo; el curso nombra los tres como alternativas a streams y tasks |
| Ingesta en streaming | Cualquiera | Snowpipe carga archivos en menos de un minuto y Snowpipe Streaming con el conector de Kafka carga filas en segundos; Databricks ejecuta pipelines de streaming en código Spark |
| ML clásico con hábitos de scikit-learn o XGBoost | Cualquiera | Snowpark ML conserva las API de scikit-learn, XGBoost y LightGBM y entrena dentro de Snowflake; Databricks combina notebooks con el seguimiento de MLflow |
| Ciencia de datos exploratoria: mirar, probar, graficar, comparar ejecuciones | Databricks | Las funciones ML en SQL de Snowflake son cuatro sentencias con modelo fijo y cada experimento es una consulta facturada; un notebook sobre un clúster Spark con MLflow está hecho para ese bucle |
| Modelos a medida, GPU, tus propios contenedores | Cualquiera | Snowpark Container Services aloja tu propio modelo o un LLM de un socio sobre GPU gestionadas por Snowflake; Databricks es un clúster Spark que configuras, con Mosaic AI para servir |
| Llamadas a LLM sobre filas gobernadas desde SQL | Snowflake | AI_SENTIMENT, AI_TRANSLATE, AI_CLASSIFY, AI_EXTRACT y AI_COMPLETE se ejecutan fila a fila dentro de un SELECT bajo el mismo RBAC que la tabla |
| Chat sobre tus propios documentos (RAG) | Snowflake, o código en Databricks | Cortex Search es un servicio de recuperación gestionado sobre una columna de texto, combinado con COMPLETE para la respuesta; en Databricks montas las piezas en código |
| Preguntas de autoservicio en lenguaje natural | Snowflake | Cortex Analyst responde preguntas sobre un modelo semántico a través de una API REST; Snowflake Copilot redacta SQL en Snowsight |
| Compartir datos con socios sin copias | Snowflake | Las comparticiones son sin copia y de solo lectura, el Marketplace las distribuye y los Clean Rooms permiten a dos partes analizar datos combinados sin ver las filas del otro |
| Mantener las tablas como archivos que controlas | Databricks | Una tabla Delta son archivos Parquet más un registro en tu propio bucket; cualquier motor Spark puede leerla |
| Apps de datos entregadas a usuarios de negocio | Snowflake | Streamlit en Snowflake se despliega con un clic bajo los roles existentes; el Native App Framework vende apps en el Marketplace |
| Aprender gratis en un portátil | Databricks | Spark y Delta Lake se instalan con pip; Snowflake necesita una cuenta, aunque la de prueba cubre casi todo el curso |
La capa de IA: Cortex frente a Mosaic AI
Los dos fabricantes ponen los modelos junto a los datos, pero la forma de la oferta es distinta.
| Snowflake Cortex | Databricks Mosaic AI | |
|---|---|---|
| Cómo llamas a un modelo | Funciones SQL dentro de SELECT, o la CLI snow cortex | Código en notebooks, endpoints de servicio de modelos |
| Tareas listas para usar | AI_SENTIMENT, AI_TRANSLATE, AI_EXTRACT, AI_CLASSIFY, AI_PARSE_DOCUMENT, AI_COMPLETE | Se construyen con tus propios modelos o modelos alojados |
| Recuperación para RAG | Servicio Cortex Search sobre una columna de texto | Se monta en código |
| De lenguaje natural a respuestas | Cortex Analyst sobre un modelo semántico; Copilot en Snowsight | No está en mis notas |
| Modelos a medida | Cortex Fine-Tuning; Snowpark Container Services con GPU | MLflow, servicio de modelos, clústeres Spark |
| ML clásico en SQL | FORECAST, ANOMALY_DETECTION, TOP_INSIGHTS, CLASSIFICATION | MLflow y notebooks |
| Gobernanza | Los mismos roles que las tablas; los datos nunca salen | Unity Catalog |
El curso sitúa Cortex en un espectro que va de los segundos (AI/ML Studio, sin código) a los minutos (una función SQL) y a las horas (un contenedor con tu propio modelo). Databricks empieza por el extremo de las horas y avanza hacia atrás: tienes el clúster Spark completo y MLflow, y construyes hacia arriba. Cuál es mejor depende de quién pregunta: un analista que escribe SQL llega más lejos en Snowflake; un equipo que ya entrega modelos desde notebooks llega más lejos en Databricks.
Dónde Snowflake deja de ser una herramienta de exploración en ML e IA
Una diapositiva del curso resume mi principal reserva, y es la razón por la que no pondría el trabajo de exploración de un equipo de ciencia de datos en Snowflake:
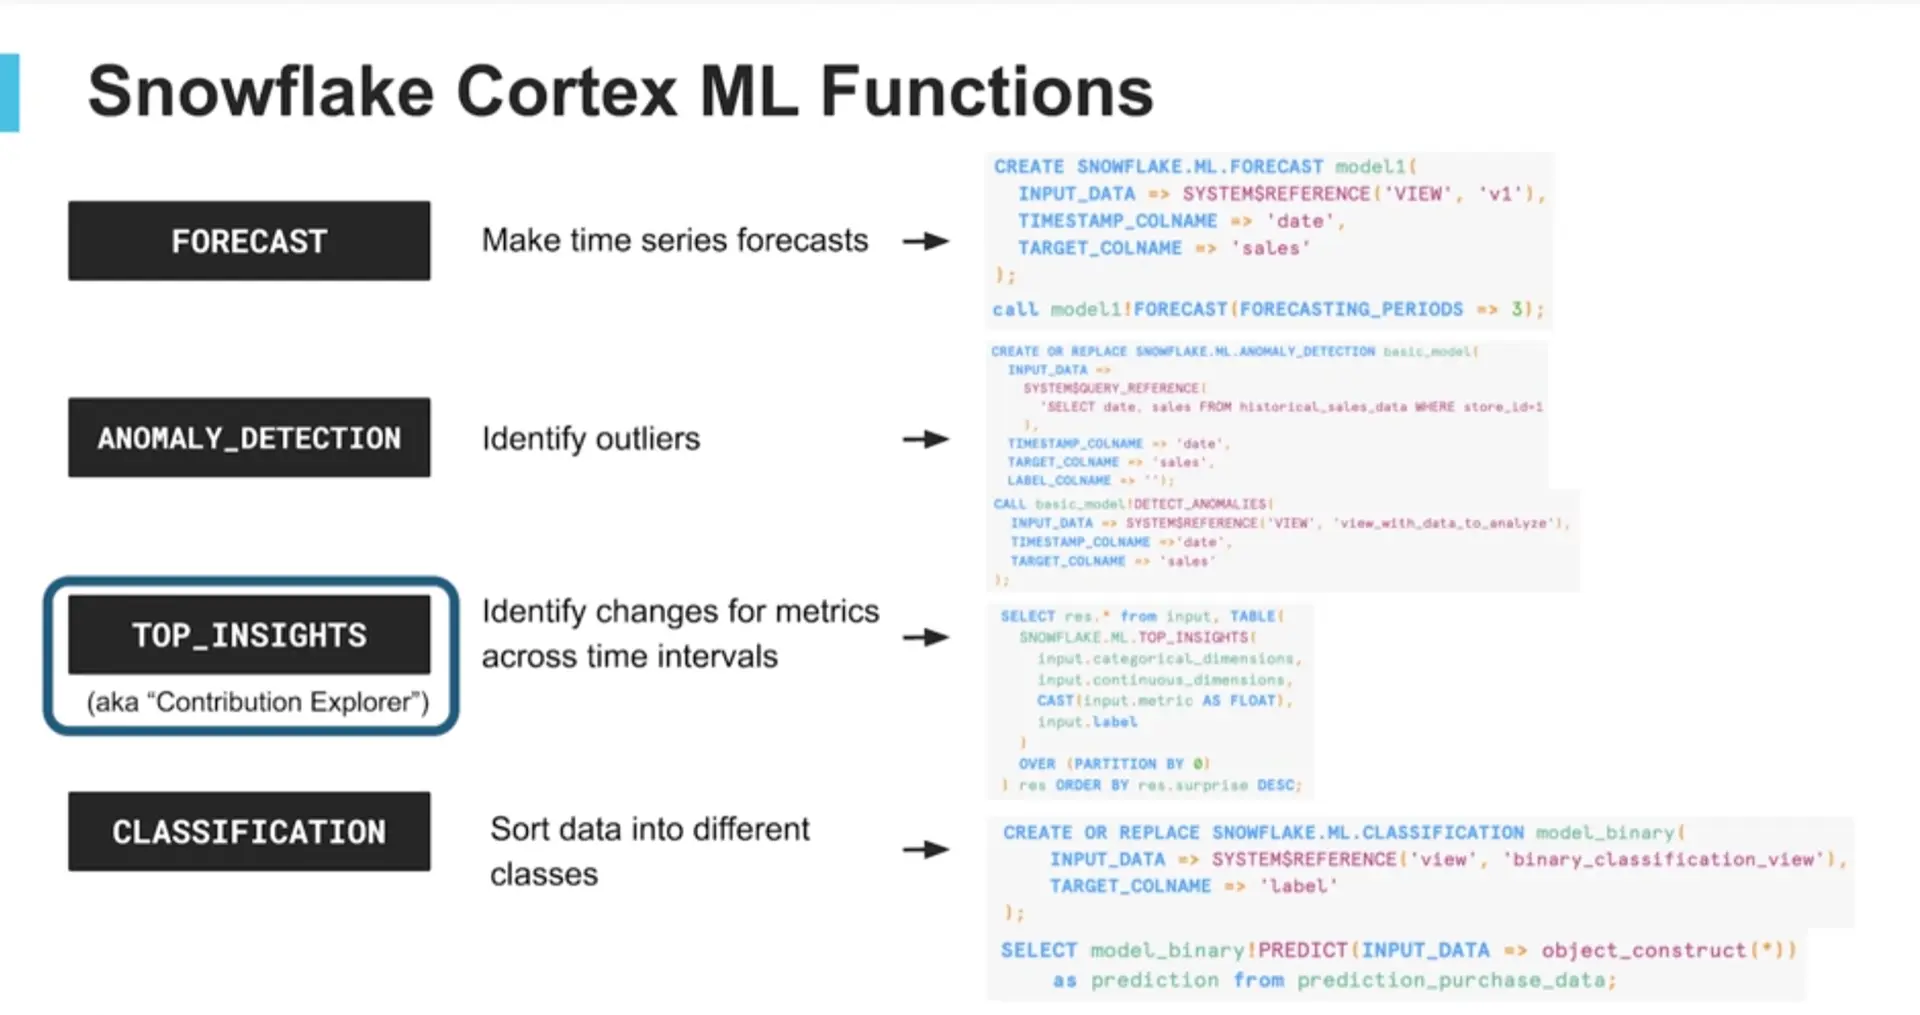
Lo que muestra la diapositiva. Toda la caja de herramientas de aprendizaje automático del lado SQL son cuatro funciones. Cada una se crea de la misma forma: una referencia a una vista como INPUT_DATA, un TIMESTAMP_COLNAME, un TARGET_COLNAME, y después una llamada como model1!FORECAST(FORECASTING_PERIODS => 3) o model_binary!PREDICT(INPUT_DATA => object_construct(*)). Ese es todo el bucle de entrenamiento. El curso añade que FORECAST, ANOMALY_DETECTION y CLASSIFICATION ejecutan por debajo una máquina de gradient boosting, y ese es el único modelo disponible.
Por qué eso es un problema para explorar. La ciencia de datos es un bucle: mirar los datos, probar una transformación, entrenar, graficar, comparar, volver atrás. Desde esta interfaz no puedes elegir el algoritmo, ajustarlo más allá de los parámetros con nombre, construir características en otro sitio que no sea el SQL de la vista de entrada, inspeccionar una curva de aprendizaje, comparar dos ejecuciones lado a lado ni conservar un historial de experimentos. La sentencia devuelve una respuesta, que es exactamente lo adecuado cuando la pregunta está cerrada y no ayuda en nada mientras no lo está. Incluso el escaparate del curso para el modelado "de verdad", la demo de XGBoost con Snowpark ML, informa de 730 de 730 predicciones de prueba correctas sobre 7.300 filas sintéticas: una demostración de la API, no un flujo de modelado.
El lado generativo tiene la misma forma. AI_SENTIMENT o AI_COMPLETE devuelven una respuesta por fila con el modelo como parámetro. La demo fila a fila del curso se limita a 5 filas mientras se ajusta el prompt, porque cada llamada es una consulta facturada sobre un almacén en marcha y un modelo mayor cuesta más por token, y Cortex Search ni siquiera funcionó en la cuenta de prueba porque los embeddings requieren una de pago. Eso es aceptable para puntuar datos gobernados en producción. Es un mal sitio para explorar: sin iteración local barata, sin registro de experimentos, y cada intento aparece en la factura.
Lo que Snowflake ofrece a cambio, y por qué no cambia el veredicto. Snowpark ML lleva al cómputo de Snowflake API al estilo de scikit-learn, XGBoost y LightGBM, un Model Registry y un Feature Store, y el curso tiene razón en que supera a los procedimientos almacenados y las UDF que había antes. Pero traslada los hábitos de scikit-learn a los notebooks y almacenes de Snowflake; no convierte la plataforma en un entorno de exploración. Databricks empieza por el otro extremo: un notebook sobre un clúster Spark, MLflow registrando cada ejecución, y el SQL se añade después. Si el día a día de un equipo es explorar y no puntuar, esa diferencia decide la elección por sí sola.
Un grafo de decisión sencillo
Aprender los dos sin factura en la nube
| Corre en local | Coste | Sirve para | |
|---|---|---|---|
| Apache Spark con PySpark | Sí | Gratis | Desarrollo con Spark, DataFrames, Spark SQL |
| Spark con Delta Lake | Sí | Gratis | Tablas lakehouse, viaje en el tiempo, MERGE, capas medallion |
| Databricks Free Edition | No, gestionado en la nube | Gratis, con cuotas serverless y límites de funciones | El espacio de trabajo real, Unity Catalog, Lakeflow |
| Databricks Connect | En parte: IDE local, clúster remoto | El cómputo puede facturarse | Desarrollar en local contra un clúster real |
| Cuenta de prueba de Snowflake | No, gestionado en la nube | Gratis durante el periodo de prueba | Snowsight, almacenes, Time Travel, clonado, casi todo Cortex |
| Snowflake CLI y extensión de VS Code | Sí, contra cualquier cuenta | Herramientas gratuitas | Scripts, CI, editar SQL y Python en tu editor |
| Snowpark en local | Sí, contra cualquier cuenta | Librería gratuita | DataFrames que se ejecutan dentro del cómputo de Snowflake |
Para el lado de Databricks, un lakehouse local funcional está a un comando de distancia:
python3 -m venv spark-env && source spark-env/bin/activate
pip install pyspark delta-spark jupyterlab
jupyter lab
Con eso puedes practicar transformaciones en PySpark, Spark SQL y funciones de ventana, tablas Delta con viaje en el tiempo, capas bronze, silver y gold, cargas incrementales con MERGE INTO y pipelines por lotes o en streaming. Lo que no tienes en local es la plataforma en sí: Photon, la gobernanza gestionada de Unity Catalog y los servicios propios de Databricks. Databricks Free Edition los cubre, dentro de sus cuotas.
Para el lado de Snowflake, la cuenta de prueba cubre casi todo el curso; lo único que falló en una cuenta de prueba durante el curso fue Cortex Search, porque los embeddings requieren una cuenta de pago. En local instalas la CLI y la librería de Snowpark:
pip install snowflake-cli snowflake-snowpark-python
snow connection add && snow connection test
snow sql -q "SELECT CURRENT_VERSION()"
Cuando necesité un entorno con forma de Snowflake que arrancara en segundos sin credenciales, construí uno sobre DuckDB organizado como una cuenta de Snowflake, con esquemas bronze, silver y gold, un esquema account_usage, políticas de enmascarado y de acceso por filas aplicadas en SQL, y el mismo diseño entregado como DDL real de Snowflake para el modo en vivo. Ese proyecto es el Snowflake AI Data Copilot.
Qué elegiría yo
Si quienes hacen las preguntas escriben SQL y las respuestas van a dashboards, informes y conjuntos de datos compartidos, empiezo con Snowflake: almacenes que se dimensionan según el trabajo, tablas dinámicas en lugar de un planificador, y Cortex para sentimiento, traducción, clasificación y preguntas en lenguaje natural sin exportar una sola fila.
Si quienes hacen el trabajo escriben Python contra archivos grandes, entrenan sus propios modelos y quieren que las tablas se queden en sus propios buckets como archivos abiertos, empiezo con Databricks: Spark es el lenguaje nativo, Delta Lake es el formato nativo, y MLflow y Mosaic AI son las herramientas nativas para modelos. Y si el trabajo es explorar y no puntuar, Databricks gana antes de sopesar cualquier otro criterio.
Si una empresa ya tiene los dos, la conversación útil no es cuál sino qué carga va a cada sitio, y la única regla que evita que se peleen son los formatos de tabla abiertos: Iceberg en el lado de Snowflake, Delta y Parquet en el de Databricks, para que ninguna plataforma se convierta en la única capaz de leer los datos.
Fuentes
- Coursera, Intro to Snowflake for Devs, Data Scientists, Data Engineers, de Snowflake (instructor Peter Olson), transcripción revisada el 5 de noviembre de 2026. Cada definición, comando y cifra de Snowflake de este artículo es del curso; el curso completo está en el mapa mental de Snowflake. Algunas funciones estaban en vista previa al grabarse, así que consulta docs.snowflake.com para la disponibilidad y los precios actuales.
- Documentación y páginas de producto de Databricks en docs.databricks.com para Apache Spark, Delta Lake, Unity Catalog, Lakeflow, MLflow, Mosaic AI, Databricks Connect y Free Edition, según mis notas de estudio de noviembre de 2026. Las cuotas y los límites de la Free Edition cambian; consulta las condiciones vigentes.
Preguntas que responde
¿Databricks es un framework, un motor o una plataforma?
Una plataforma. Apache Spark es el motor que ejecuta el trabajo, Delta Lake es el formato de tabla que añade transacciones a los archivos, y Databricks es el espacio de trabajo gestionado que los combina con Unity Catalog, SQL warehouses, Lakeflow, MLflow y Mosaic AI sobre AWS, Azure o Google Cloud.
¿Databricks guarda mis datos en su propia base de datos?
No. Una tabla Delta es una carpeta de archivos Parquet más un directorio _delta_log en tu propio almacenamiento de objetos, como S3, Azure Data Lake Storage o Google Cloud Storage. Databricks aporta el cómputo, el catálogo y el espacio de trabajo; los archivos se quedan en tu cuenta en la nube.
¿Dónde guarda Snowflake los datos?
En su capa de almacenamiento optimizado, construida sobre almacenamiento de objetos en la nube y gestionada por Snowflake: el microparticionado, la compresión y el cifrado corren de su cuenta, y admite formatos de tabla abiertos como Apache Iceberg para los datos que mantienes fuera. Nunca gestionas los archivos directamente.
¿Cuál es mejor para IA generativa?
Siguen caminos distintos. Snowflake Cortex expone funciones LLM como AI_SENTIMENT, AI_TRANSLATE, AI_CLASSIFY y AI_COMPLETE dentro de SQL, más Cortex Search para recuperación y Cortex Analyst para preguntas en lenguaje natural sobre un modelo semántico, todo bajo el mismo control de acceso por roles que las tablas. Databricks ofrece Mosaic AI y servicio de modelos sobre MLflow para equipos que construyen y alojan sus propios modelos en código.
¿Es Snowflake una buena plataforma para explorar en aprendizaje automático?
En mi opinión, no. La caja de herramientas del lado SQL son cuatro funciones ML de Cortex (FORECAST, ANOMALY_DETECTION, TOP_INSIGHTS, CLASSIFICATION) que entrenan un modelo de gradient boosting fijo a partir de una vista y devuelven una respuesta: sin elección de algoritmo, sin ingeniería de características fuera de SQL, sin historial de experimentos y con cada llamada de IA facturada como consulta. Snowpark ML añade API al estilo de scikit-learn dentro de Snowflake, lo que ayuda a entrenar a escala, pero un notebook en Databricks con MLflow está hecho para el bucle de exploración.
¿Puedo practicar cualquiera de los dos sin pagar cómputo en la nube?
Sí. Para el lado de Databricks, instala pyspark y delta-spark con pip y ejecuta Spark con Delta Lake en local, o usa Databricks Free Edition, que tiene cuotas de cómputo serverless y límites de funciones. Para Snowflake, usa una cuenta de prueba con Snowsight, la Snowflake CLI y la extensión de VS Code; algunas funciones, como los embeddings de Cortex Search, requieren una cuenta de pago.
¿Puede una empresa usar los dos?
Sí, y muchas lo hacen: por ejemplo Databricks para la ingeniería pesada en Spark y el entrenamiento de modelos, y Snowflake para la analítica SQL gobernada, la compartición y las apps de datos. La condición práctica es mantener los datos compartidos en formatos de tabla abiertos para que cada lado pueda leer lo que escribe el otro.
Etiquetas:snowflakedatabricksdata engineeringdata platformslakehousegenerative aimachine learning
Proyectos relacionados
Snowflake AI Data Copilot: cifras fiables, IA y menos coste
Bases de datos e ingeniería de datos · IA y agentes · Cloud, DevOps y LLMOps
Virgil.ai: asistente agéntico de seguros de salud
IA y agentes · ERP y SaaS con IA · Cloud, DevOps y LLMOps · Seguridad y cumplimiento
Plataforma de análisis de parcelas con IA para una constructora
IA y agentes · Full-Stack y UI/UX · Ciencia de datos y ML
¿Necesitas construir algo así? Mira mis Servicios · Portfolio