
AI
El gran cambio de la IA: del machine learning tradicional a los LLM, y por qué el RL para robótica es lo siguiente
Por David Gadyan · Publicado el · 7 min de lectura
En ocho años el trabajo pasó de entrenar un modelo a medida por tarea a integrar modelos fundacionales con recuperación, herramientas y evaluaciones. El siguiente cambio ya se ve: el aprendizaje por refuerzo sale del laboratorio y entra en los robots. Qué significa eso para quien construye un producto hoy.
Llevo lanzando IA para clientes desde 2018, primero como científico de datos en Upwork y hoy como ingeniero de IA y científico de datos EXPERT-VETTED que construye agentes de IA, productos de IA generativa y SaaS de principio a fin. En esos ocho años el trabajo cambió más de una vez. No el objetivo, que siempre fue un sistema que mueva una cifra del negocio, sino las herramientas, las habilidades e incluso la definición de «construir un modelo». Este es el cambio tal y como lo viví, y hacia dónde creo que va a continuación.
2016 a 2020: los años de la ingeniería de features
Cuando acepté mis primeros contratos de machine learning, «IA» en un brief significaba un pipeline de scikit-learn. El trabajo real era un ochenta por ciento datos: limpiar, cruzar, deduplicar, construir features a mano. El gradient boosting ganaba en casi todos los problemas tabulares, y por eso XGBoost está detrás de proyectos como mi modelo de valoración automática para inmobiliaria. El deep learning quedaba reservado para imágenes y señales, como el detector de fatiga del conductor que corre en hardware edge, y el trabajo con lenguaje significaba modelos de tópicos, LSTM y muchas expresiones regulares.
Cada problema tenía su propio modelo. Cada modelo era frágil: un cambio en la distribución de entrada, una nueva fuente de datos o una columna renombrada podían romperlo, y nadie fuera del equipo sabía decir por qué. Los modelos eran ingeniosos, pero no generalizaban, y el coste de cada nuevo caso de uso era más o menos el coste del primero.
2020 a 2022: transformers por todas partes
La primera grieta en ese patrón fue el transfer learning. Los transformers preentrenados como BERT hicieron posible ajustar un clasificador de texto potente con unos pocos miles de ejemplos en lugar de construir features. Cuando clasifiqué empresas por sector, la línea base salió de un modelo preentrenado y el proyecto pasó a ir de datos y evaluación, no de arquitectura. Seguía siendo un modelo por tarea, pero el punto de partida había pasado de cero a «casi todo el camino hecho».
2023 hasta hoy: el modelo es una API
Entonces los grandes modelos de lenguaje llegaron a los productos y el trabajo cambió de forma. Para la mayoría de las empresas la pregunta ya no es «¿podemos entrenar un modelo?», sino «¿cómo integramos un modelo fundacional de forma segura, barata y medible en lo que ya tenemos?». El oficio se desplazó hacia:
- Recuperación. Fundamentar las respuestas en tus propios documentos, como en el chatbot de regulación cripto construido sobre un vector store, para que el modelo responda a partir de evidencias y las cite.
- Agentes y herramientas. Flujos de trabajo de varios pasos que ejecutan acciones, no solo responden: el agente de revisión de documentos legales ejecuta comprobaciones de verificación a través de API externas, y los servidores de herramientas MCP permiten que un asistente lea un calendario o lance una búsqueda en lugar de limitarse a describir cómo hacerlo.
- Operaciones. Conjuntos de evaluación, presupuestos de coste y latencia, monitorización, guardarraíles y cumplimiento normativo. El asistente Virgil.ai solo llegó a ser utilizable por un corredor con licencia gracias al tratamiento de datos guiado por la HIPAA alrededor del modelo, no gracias al modelo en sí.
El diferenciador ya no es el modelo. Todo el mundo tiene acceso a los mismos modelos. El diferenciador son los datos a los que puedes llegar, las herramientas que expones, la experiencia de usuario y la fiabilidad del sistema completo. Por eso el trabajo ahora abarca todo el stack: interfaz, back end, base de datos, despliegue, seguridad y la analítica que demuestra que la funcionalidad funcionó.
Lo que no cambió es la parte poco glamurosa. La calidad de los datos sigue decidiendo los resultados. Sigues necesitando una evaluación medible antes de lanzar. Sigues necesitando un despliegue que puedas observar. Los equipos que se lo saltan porque «el modelo ahora es listo» lo redescubren en producción.
El próximo gran cambio: el aprendizaje por refuerzo sale del laboratorio
El aprendizaje por refuerzo (RL) es la técnica que venció al mejor jugador de Go del mundo en 2016, y durante años se quedó en una historia de investigación con usos industriales acotados. Dos cosas cambiaron. Primero, el RL a partir de feedback humano es lo que convirtió los modelos de lenguaje en bruto en asistentes que la gente puede usar de verdad. Segundo, la generación actual de modelos de razonamiento se entrena con RL en tareas donde la respuesta se puede comprobar, como las matemáticas y el código, y de ese entrenamiento viene buena parte de su mejora reciente. El RL dejó de ser una curiosidad académica y pasó a formar parte del pipeline de producción de los modelos que llamas cada día.
La frontera que sigue es física. Los simuladores ya son lo bastante buenos para entrenar políticas de control para robots a escala, con físicas aleatorizadas para que la política se transfiera al hardware real. Los modelos visión-lenguaje-acción conectan percepción, lenguaje y órdenes motoras en una sola red. El hardware de los robots, humanoides incluidos, es cada año más barato. Junta todo eso y la división del trabajo queda clara: el modelo de lenguaje planifica en palabras, la política aprendida por RL ejecuta en el mundo, y el robot deja de estar preprogramado y pasa a estar entrenado.
Espero un giro fuerte hacia el RL para robótica en los próximos años, y espero que se parezca a lo que fue la ola de los LLM: unos pocos modelos generalistas entrenados por grandes laboratorios y, después, una larga cola de trabajo de integración en almacenes, fábricas, inspección, agricultura y cuidados. Las salvedades honestas son reales. La eficiencia de muestras sigue siendo pobre, la brecha entre simulación y realidad pasa factura, las restricciones de seguridad importan mucho más cuando un error mueve un motor en lugar de una palabra, y el hardware cuesta dinero. El progreso será desigual. Pero la dirección está marcada, y las empresas que saldrán beneficiadas serán las que tengan los datos, los simuladores y las habilidades de integración listos cuando lleguen los modelos.
Qué significa esto si estás construyendo un producto ahora
- No entrenes lo que puedes resolver con un prompt. Empieza con un modelo fundacional, recuperación y un buen diseño de herramientas. Entrena tu propio modelo solo cuando tengas los datos que demuestren que el prompting no puede cerrar la brecha.
- Invierte en evaluación y en pipelines de datos. Sobreviven a cualquier modelo. El equipo con un conjunto de evaluación limpio cambia de modelo en un día; el equipo que no lo tiene discute por sensaciones.
- Diseña para cambiar de modelo. Abstrae el modelo detrás de tu propia interfaz, presupuesta coste y latencia y da por hecho que cambiarás de proveedor.
- Mantén a las personas en el circuito donde está regulado. Las decisiones de salud, finanzas y derecho necesitan trazas de auditoría, pasos de verificación y un tratamiento de datos conforme al RGPD o a la HIPAA desde la primera versión.
- Vigila el RL y la robótica si tocas el mundo físico. La logística, la fabricación, la inspección y las operaciones de campo sentirán el próximo cambio antes que nadie.
Si quieres ayuda para convertir cualquiera de estas ideas en un producto que funcione, eso es exactamente lo que hago, desde la interfaz hasta el despliegue y el seguimiento que demuestra que funcionó. Trae el problema, no una especificación.
Preguntas que responde
¿Ha muerto el machine learning tradicional ahora que existen los LLM?
No. El gradient boosting sigue ganando en la mayoría de los problemas tabulares, como la fijación de precios, el churn y el riesgo de crédito, y un clasificador pequeño es más barato y más predecible que un modelo de lenguaje para tareas acotadas. Lo que cambió es el punto de partida: primero haces prompting y después entrenas cuando los datos demuestran que lo necesitas.
¿Debería una empresa hacer fine-tuning de su propio LLM?
Rara vez como primer paso. La recuperación sobre tus propios documentos, un diseño cuidadoso de las herramientas y la evaluación llevan a la mayoría de los equipos mucho más lejos por mucho menos dinero. El fine-tuning compensa cuando tienes una tarea estable, datos etiquetados limpios y una brecha medida que el prompting no puede cerrar.
¿Por qué espera David que el aprendizaje por refuerzo para robótica sea el próximo cambio?
Porque los ingredientes están convergiendo: el aprendizaje por refuerzo ya mejora los modelos de razonamiento, los simuladores son lo bastante buenos para entrenar políticas de control a escala y el hardware de los robots es cada vez más barato. Cuando un modelo de lenguaje planifica y una política aprendida ejecuta, los robots dejan de estar preprogramados y pasan a estar entrenados.
Etiquetas:artificial intelligencemachine learninglarge language modelsreinforcement learningroboticsai strategy
Proyectos relacionados
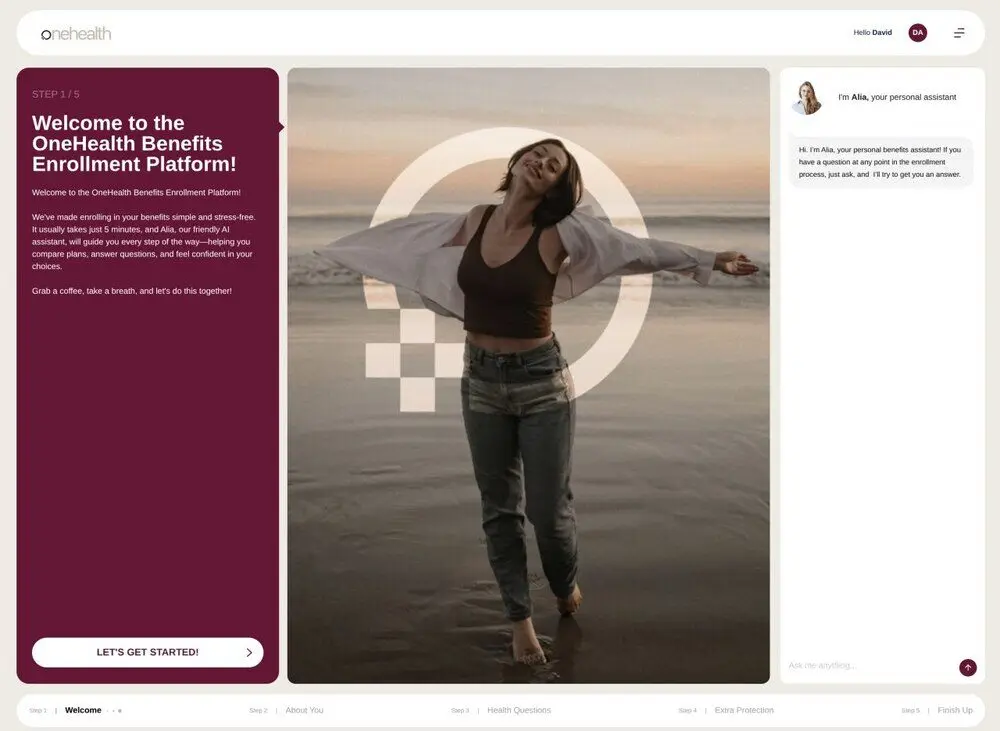
Virgil.ai: asistente agéntico de seguros de salud
IA y agentes · ERP y SaaS con IA · Cloud, DevOps y LLMOps · Seguridad y cumplimiento
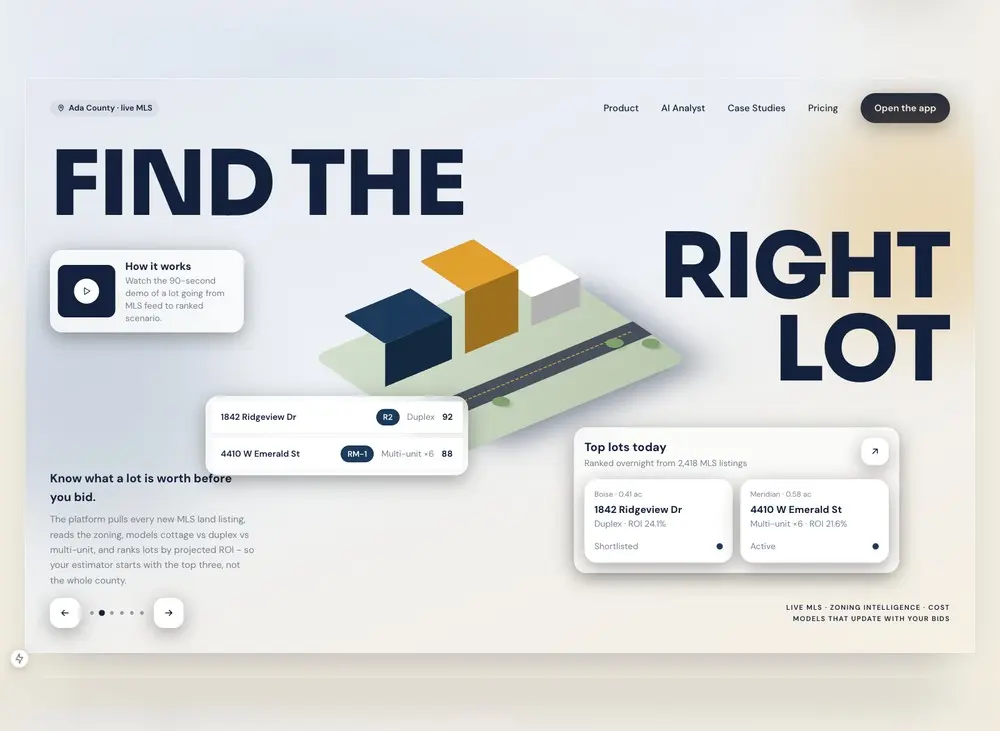
Plataforma de análisis de parcelas con IA para una constructora
IA y agentes · Full-Stack y UI/UX · Ciencia de datos y ML
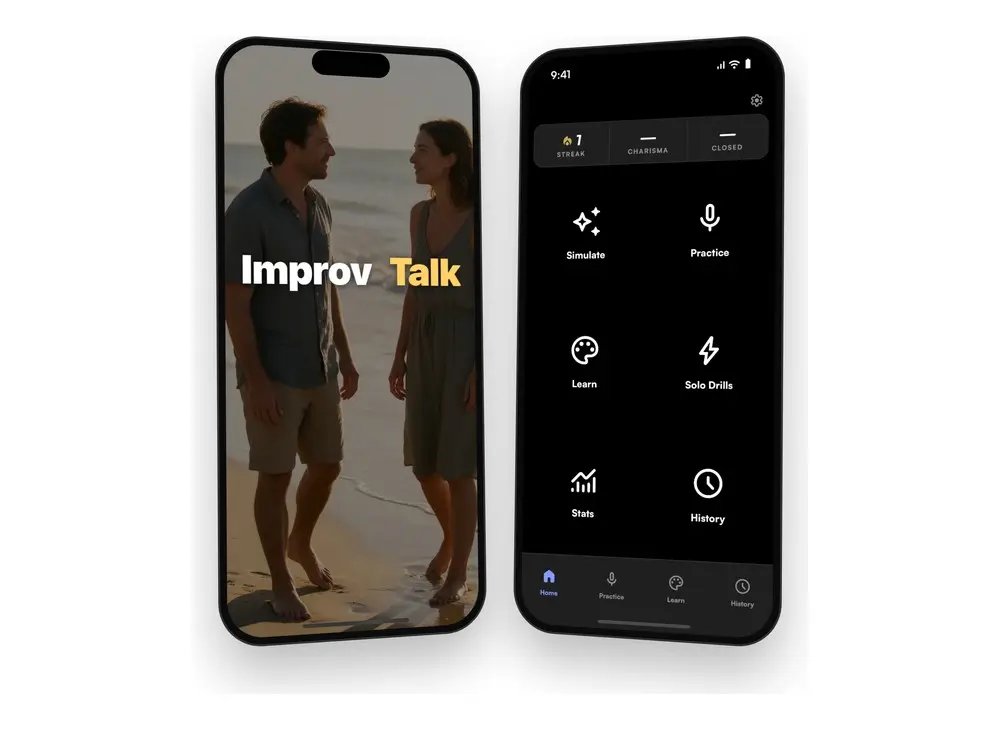
ImprovTalk: coach de IA en React Native para carisma y rapport
Full-Stack y UI/UX · IA y agentes · Marketing con IA y analítica
¿Necesitas construir algo así? Mira mis Servicios · Portfolio