
Ciencia de datos y ML · IA y agentes
Clasificación sectorial de empresas (BERT + etiquetado con GPT-4)
Por David Gadyan · Publicado el · Actualizado el · Cliente: Andrew Miles
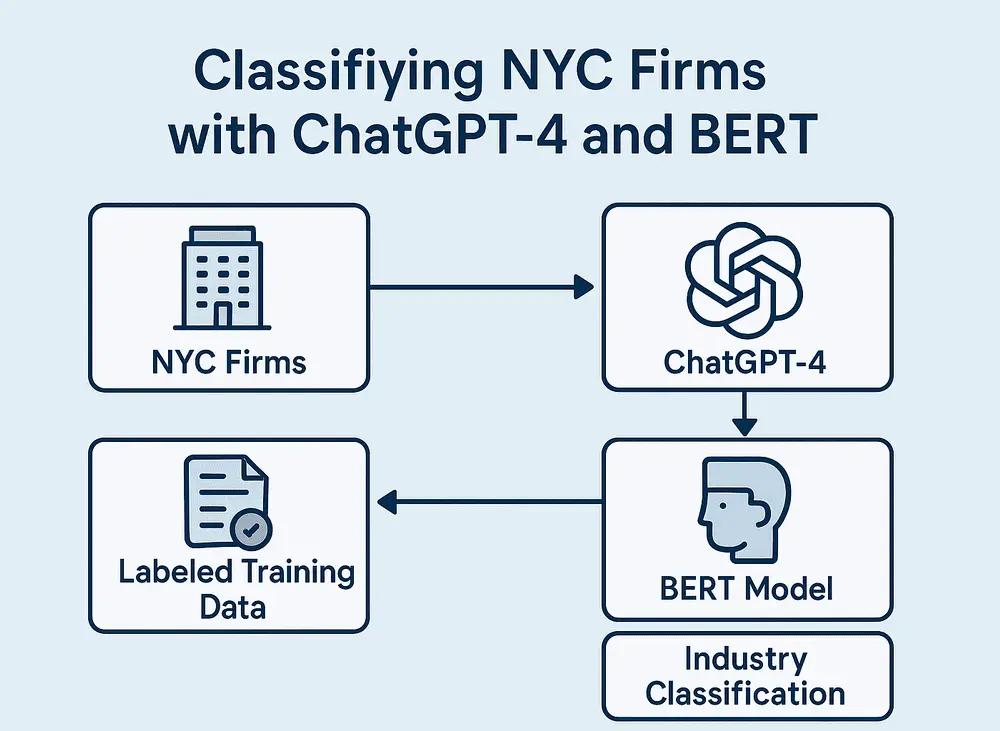
Pipeline que asigna códigos NAICS/SIC a empresas de Nueva York sin etiquetas. El emparejamiento difuso por nombre y ubicación con registros recupera códigos conocidos, el etiquetado few-shot con GPT-4 amplía el conjunto de entrenamiento sin anotación manual y un clasificador BERT, comparado con SVM y Random Forest, predice los códigos del resto, con revisiones de calidad y paquete de replicación.
El problema
El cliente tenía registros de empresas de Nueva York con solo un nombre, un propietario, una dirección, código postal, ciudad y estado, y los años de constitución o disolución, sin ninguna etiqueta sectorial. Necesitaba códigos NAICS/SIC para todas las empresas, a escala, y la anotación manual no era una opción con ese volumen.
Qué construí
- Una etapa de emparejamiento que vincula cada empresa sin etiquetar con registros secundarios mediante emparejamiento difuso de cadenas por nombre y emparejamiento por ubicación sobre direcciones, recuperando los códigos NAICS/SIC conocidos allí donde hay coincidencia.
- Un conjunto de entrenamiento etiquetado, montado a partir de las coincidencias válidas y ampliado con etiquetado few-shot con GPT-4, de modo que la cobertura creció sin que nadie anotara registros a mano.
- Un clasificador basado en BERT en Python que predice los códigos sectoriales de las empresas que no se pudieron emparejar, elegido tras compararlo con líneas base SVM y Random Forest y optimizado tanto en precisión como en coste de inferencia.
- Controles de calidad en forma de revisiones manuales aleatorias, tanto de los emparejamientos con registros como de las predicciones del modelo, para mantener alta la calidad de los datos.
- Documentación completa y un paquete de replicación que cubre la lógica de emparejamiento, la estrategia de etiquetado y los flujos de entrenamiento e inferencia.
Cómo se entregó
Fui el único ingeniero. En lugar de entregar solo las predicciones, entregué el pipeline como algo que los responsables del cliente pueden volver a ejecutar: la documentación y el paquete de replicación reproducen de principio a fin la lógica de emparejamiento, la estrategia de etiquetado y el entrenamiento e inferencia del modelo.
Resultado
Todas las empresas del conjunto de datos acaban con un código NAICS/SIC: las emparejadas, a partir de los registros; el resto, a partir de un clasificador BERT entrenado con un conjunto que GPT-4 ayudó a etiquetar. Las revisiones aleatorias de calidad mantienen honestas ambas etapas, y el paquete de replicación permite reproducir el flujo en lugar de tratarlo como una ejecución puntual.
Proyectos relacionados
Plataforma de análisis de parcelas con IA para una constructora
IA y agentes · Full-Stack y UI/UX · Ciencia de datos y ML
Análisis de currículums con NLP y LLM
Ciencia de datos y ML · IA y agentes
Visión artificial con YOLO26/27: tres demos listas para edge
Visión artificial y medios generativos · Ciencia de datos y ML · Cloud, DevOps y LLMOps