
Finanzas y quant · Ciencia de datos y ML
Pipeline cuantitativo de PCA sobre la curva de tipos (Bloomberg)
Por David Gadyan · Publicado el · Actualizado el · Cliente: Jonathan Cooper
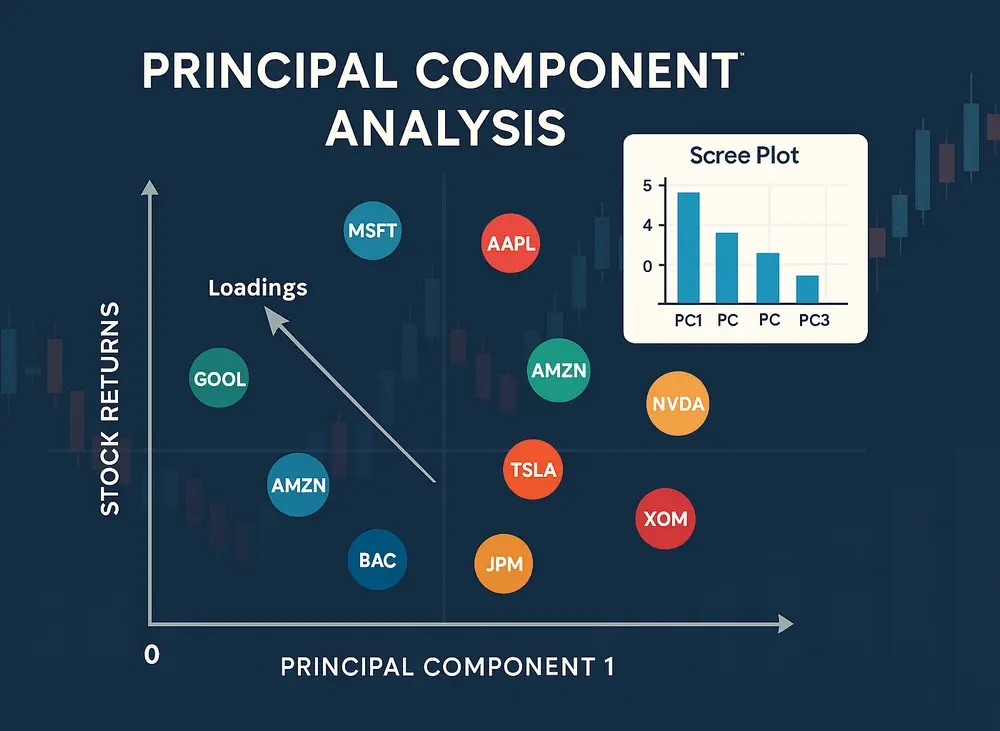
Pipeline cuantitativo en Python que extrae la curva de tipos por sectores de Bloomberg vía xbbg, la estandariza con pandas, numpy y StandardScaler y aplica PCA de scikit-learn para obtener los movimientos dominantes. Los residuos de reconstrucción señalan automáticamente los sectores caros o baratos, un KMeans opcional agrupa patrones similares y gráficos de Matplotlib y Plotly permiten la revisión interactiva.
El problema
Una curva de tipos se mueve sobre todo a lo largo de unos pocos factores dominantes, y un sector que se aleja de lo que esos factores implican está caro o barato respecto al resto de la curva. Detectarlo a ojo en muchos sectores es lento e inconsistente. El cliente quería un pipeline en Python ágil que extrajera los datos de Bloomberg, ejecutara la descomposición y señalara los sectores mal valorados sin trabajo manual.
Qué construí
- Ingesta de datos desde Bloomberg a través de la librería xbbg, cargando las series de la curva de tipos sector por sector en pandas.
- Preprocesado con pandas, numpy y el StandardScaler de scikit-learn para que todos los sectores estén en una escala comparable antes de la descomposición.
- Análisis de componentes principales (PCA) con scikit-learn para extraer los movimientos dominantes de la curva entre sectores.
- Reconstrucción de los tipos de cada sector a partir de los componentes principales más importantes, usando el residuo entre el tipo real y el reconstruido para marcar automáticamente los segmentos como caros o baratos.
- Clustering opcional con KMeans para agrupar los sectores cuyos patrones de residuos se parecen.
- Salida visual en Matplotlib para gráficos estáticos y en Plotly para el análisis interactivo.
Datos e infraestructura
Los datos vienen directamente de Bloomberg a través de xbbg, de modo que todo el flujo, desde descargar las curvas hasta señalar los sectores mal valorados, se ejecuta como un único programa en Python y no como una cadena de exportaciones manuales y hojas de cálculo.
Resultado
El PCA extrae los movimientos dominantes de la curva y los residuos de reconstruir cada sector señalan automáticamente los segmentos mal valorados. El KMeans opcional agrupa los patrones de residuos similares, y la salida en Plotly permite al cliente profundizar en cada señal de forma interactiva en lugar de leer tablas.
Proyectos relacionados
Contraste de hipótesis sobre tickers bursátiles
Finanzas y quant · Ciencia de datos y ML
Dashboard de tendencias y sentimiento bursátil
Ciencia de datos y ML · Full-Stack y UI/UX · Finanzas y quant
AI Trading Assistant: un copiloto fiel a tu propia estrategia
IA y agentes · Finanzas y quant · Full-Stack y UI/UX