
Bases de datos e ingeniería de datos · Ciencia de datos y ML · Cloud, DevOps y LLMOps
Web scraper con IA (LSTM + Scrapy)
Por David Gadyan · Publicado el · Actualizado el · Cliente: Robin Tar
Crawler Scrapy para Robin Tar que visita miles de sitios web de un sector y extrae la página «sobre nosotros», la dirección, las noticias y la información de empleados de cada empresa. Como cada sitio tenía una estructura HTML distinta, entrené un modelo LSTM con un conjunto etiquetado para detectar qué etiquetas contienen cada campo, sustituyendo las reglas XPath por sitio, y lo desplegué en la nube detrás del crawler.
El problema
El cliente quería un bot Scrapy que visitara miles de sitios web de un sector concreto y extrajera los datos que importan: la página «sobre nosotros» de la empresa, su dirección, noticias y, sobre todo, información sobre sus empleados. El problema era que cada uno de esos sitios tenía una estructura HTML distinta. Escribir reglas XPath por sitio nunca iba a funcionar a esa escala, y la respuesta habitual, una larga lista de selectores frágiles, se rompería tan rápido como se escribiera.
Qué construí
- Un crawler Scrapy que descarga páginas de miles de sitios web del sector.
- Un modelo de deep learning, un LSTM, que examina las etiquetas de una página y predice cuáles contienen la información que necesitamos. Una vez identificada una etiqueta, el crawler simplemente extrae su texto o sus atributos, así que la lógica de extracción deja de depender del diseño de cada sitio.
- Un conjunto de entrenamiento etiquetado para el modelo, construido con algo de ayuda, que cubre los campos objetivo en muchas estructuras de página diferentes.
- Despliegue del modelo entrenado en la nube para que el crawler pudiera invocarlo en producción y no solo en un notebook.
Cómo se entregó
El modelo se desplegó en la nube y el bot Scrapy lo invoca como parte de su paso de extracción, lo que mantiene el rastreo y la detección de etiquetas como responsabilidades separadas: Scrapy descarga, el modelo decide qué etiquetas importan y el spider extrae.
Resultado
Un único modelo aprendido sustituyó lo que habrían sido miles de reglas XPath escritas a mano, y el crawler generalizó en los diseños que fue encontrando. El LSTM funcionó bien para la tarea y se ejecutó en producción en la nube, convirtiendo un problema de scraping que no escalaba en uno que sí lo hace.
Proyectos relacionados
API de recomendación híbrida en GCP (Chilldays)
Ciencia de datos y ML · Cloud, DevOps y LLMOps · Bases de datos e ingeniería de datos
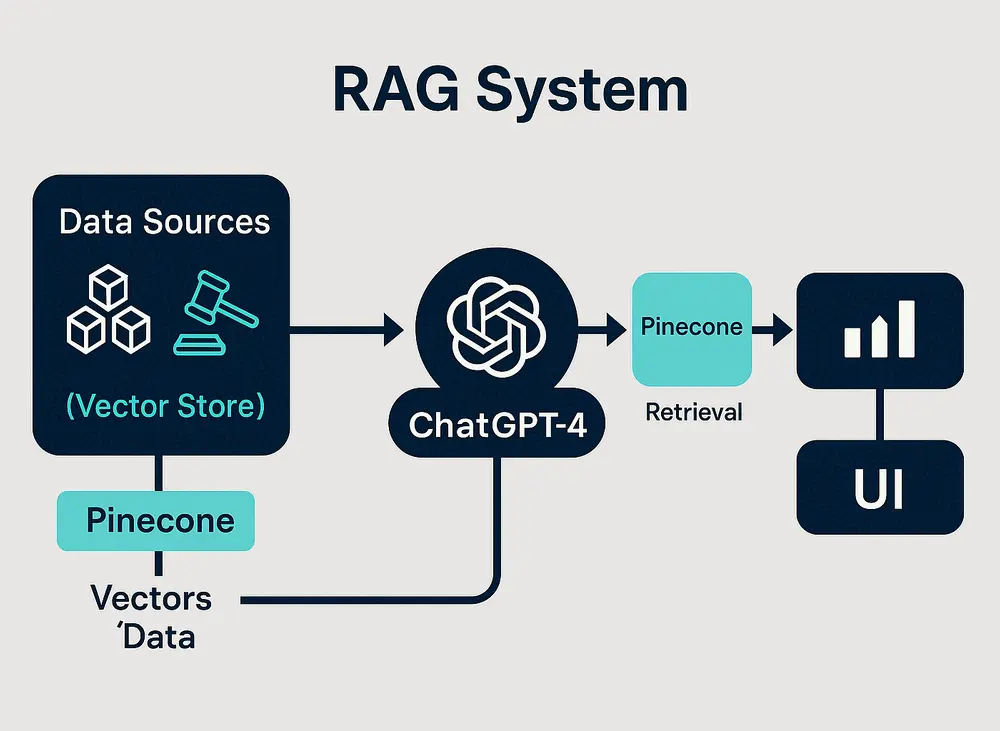
Chatbot RAG sobre regulación cripto (GPT-4 + Pinecone)
IA y agentes · Bases de datos e ingeniería de datos · Cloud, DevOps y LLMOps
Modelo de valoración automatizada y bot inmobiliario
Ciencia de datos y ML · Bases de datos e ingeniería de datos